大模型参数规模与计算边际成本之间的尖锐对立,正在不可逆转地推动混合专家架构(Mixture of Experts, MoE)走向企业级计算底座的核心舞台。传统的密集模型(Dense Models)在每次前向传播时,必须全量激活网络中的全部权重矩阵,导致推理与微调成本随着参数体量的扩张呈严格的线性增长。MoE架构通过将原本单一的前馈神经网络(FFN)拆分为一组相互独立的专家网络,并由前端门控路由动态决定代币分发,实现了知识容量的大幅跃升与单步计算成本的有效解耦。
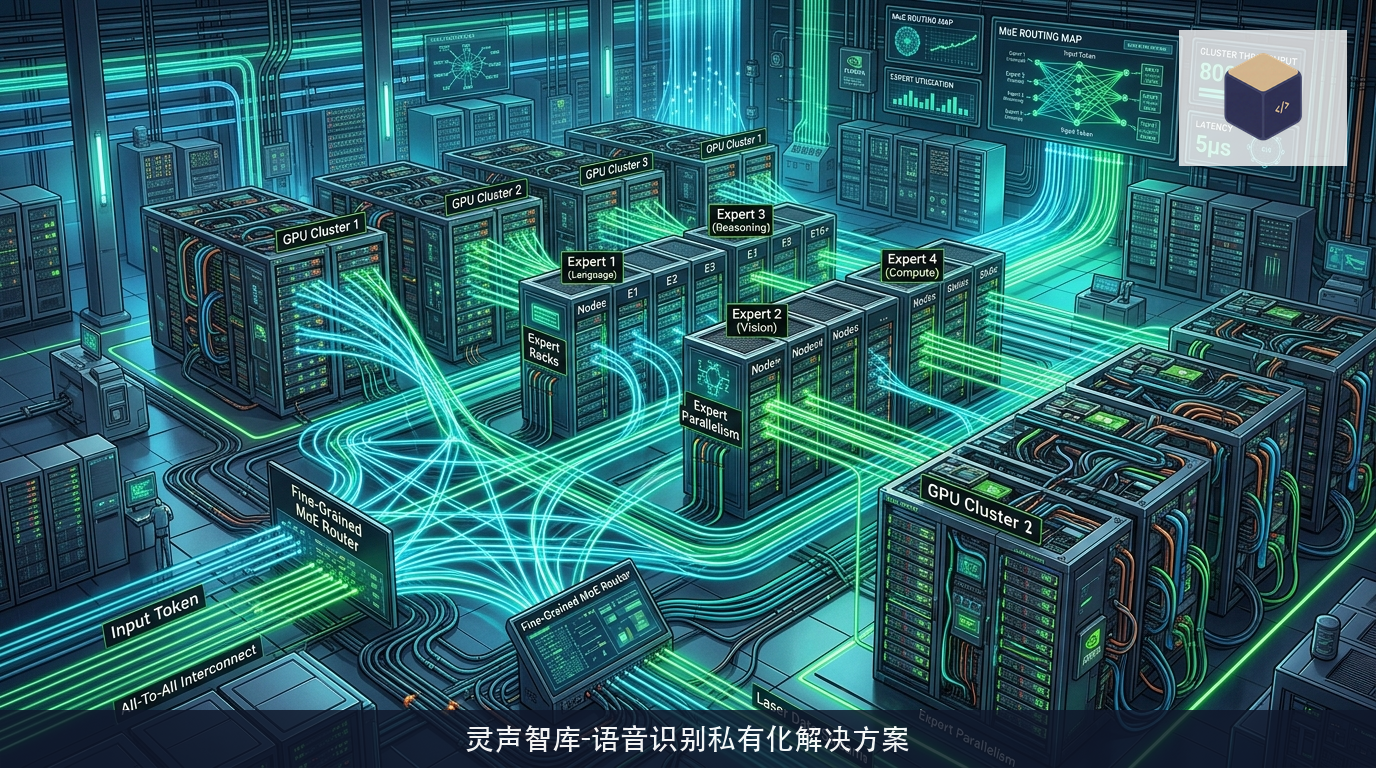
然而,开源前沿技术的最新演进表明,MoE架构正在从早期的粗颗粒度(如8专家激活2个)迅速迈向极细粒度(Fine-Grained MoE,如64或128微型专家中细分激活)。当专家粒度被大幅切割、单代币激活的专家组合多样性呈组合爆炸式上升时,私有算力集群内部的互联网络遭遇了极其残酷的通信墙制约。如何在企业私有异构算力池中化解通信拥塞,成为了考验智算系统架构师实战功底的核心技术命题。
专家细粒度解耦与共享专家的数学分工
在传统的粗颗粒度MoE设计中,由于单个专家的参数体量过大,路由网络经常陷入严重的表征冗余与负载倾斜陷阱。许多本应由底层通用语言逻辑消化的基础特征,被迫在不同的专用专家中重复拟合;同时,少数泛化能力强的专家经常被过度调用,导致在硬件层面触发严重的专家容量超载(Capacity Drop),进而引发推理质量的断崖式下跌。
细粒度专家重构从根本上重塑了这种知识分布格局:
核心改进在于将原本庞大的FFN中间隐藏层维度按固定比例等分切割,将少数几个重型专家打碎为数十个乃至上百个微型专家。在总参数量保持恒定的前提下,代币在特征匹配时的自由组合度提升了数个数量级;
与此同时,架构中明确划分出共享专家(Shared Experts)与路由专家(Routed Experts)两类物理节点:
无论输入的提示词或专业领域为何,固定的共享专家始终保持全量无条件激活。它们承担起承载通用语法规则、核心上下文结构以及基础数学逻辑的职责,将通用知识牢固沉淀在常驻显存中;
而其余的细粒度路由专家则专注于攻克长尾垂直领域的细微差异。门控网络通过计算代币嵌入向量与各个专家投影向量之间的余弦距离,并结合带有动态噪声的Softmax层,在极高稀疏度下精准激活最匹配的数个微型专家;
数学实测表明,细粒度切分极大增强了不同专家权重矩阵的正交性,显著降低了专家之间的表征冲突,使千亿级模型在极其严苛的推理算力预算下,展现出媲美超大规模密集模型的强大认知容量。
跨机专家并行(EP)与All-to-All集合通信的物理墙
虽然细粒度重构在算法层面取得了巨大成功,但当模型在私有计算集群中进行分布式专家并行(Expert Parallelism, EP)部署时,集群通信带宽迅速成为吞吐量的最大阿喀琉斯之踵。
在专家并行拓扑中,不同的专家被分散部署在不同的物理计算卡或不同服务器节点上。一个批次中的不同词元在完成注意力计算后,必须根据门控路由给出的目标专家ID,通过高速互联网络被精确发送到对应物理卡上进行前馈计算;计算完毕后,结果又必须原路传回原卡进行残差累加:
在分布式系统层面,这一过程对应着极其沉重的All-to-All(全对全交换)集合通信原语;
在单节点内部,借助高速片间总线,All-to-All数据交换的延迟通常在数微秒级别,对计算吞吐的影响尚可接受;
但当扩展至跨物理服务器的集群互联时,即使配置了高速InfiniBand或RoCE低延迟以太网,跨机通信带宽与片上显存带宽相比依然存在一到两个数量级的巨大代差;
随着专家细粒度切分程度的加深,单个批次中的词元被高度离散地派发给散布在各个节点的微型专家。海量的细碎数据包高频涌入交换网络,极易引发交换机端口的微突发(Micro-burst)拥塞。计算单元在完成注意力计算后,往往需要耗费数十甚至上百毫秒等待跨机网络通信同步,导致GPU计算核心陷入深度的算力饥饿状态。
算子级通信计算重叠与拓扑感知动态负载均衡
为了打破All-to-All通信对系统吞吐的封锁,私有算力池的优化必须直面底层CUDA内核与集群网络拓扑的软硬件协同重塑。
一线系统工程的核心突破口在于精细化的微流水线切片(Micro-pipelining):
工程团队重写了底层的通信调度内核,将批处理中的数据切分为多个独立的微块。当第N个数据微块正在执行耗时的跨机All-to-All网络传输时,计算引擎同时并发调度GPU执行第N-1个数据微块的局部专家GEMM计算;
通过让算子计算与网络I/O在时间轴上高度重叠,将绝大部分跨机集合通信开销无缝掩盖在计算背景之中,使整机系统的计算吞吐率恢复至理论上限的80%以上;
在算法调度层面,传统的辅助平衡损失往往会损害模型的语言表达精度。成熟的系统采用无辅助损失的动态偏置校准机制:
监控守护进程实时采集各物理节点的网络队列深度与显存计算负载。当检测到某个物理节点由于突发流量即将出现网络排队时,门控网络自动对该节点上的专家施加轻微的偏置惩罚,平滑将处于决策临界点上的代币分流至负载较低的同类备选专家所在节点;
在物理机架规划层面,系统通过感知机架内部的NUMA拓扑与网络交换层次,尽量将高频协同的细粒度专家组合聚类部署在同一机架甚至同一PCIe拓扑域内,将跨核心交换机的通信流量压缩至极限。这种系统级的深度压榨,为企业在有限的私有智算资产上跑通超大规模MoE模型开辟了切实可行的落地通道。