大模型技术在各行业垂直业务深水区的规模化落地,最终的检验标准在于其能否摆脱对高耗能云端服务器机柜的绝对依附,在功耗严苛受限、网络不稳定的边缘现场稳定自主运行。智能座舱、工业巡检防爆手持机、特种野外救援装备以及高安全移动终端等关键场景,普遍要求系统在完全脱离公共网络(Air-gapped)的极限工况下,具备百毫秒级的本地智能推理决策能力。
然而,传统的半精度浮点(FP16)大模型即使经历激进的模型剪枝,单参数依然需要占用2个字节的宝贵存储与显存空间。一个哪怕经过极致轻量化精简的7B小模型,静态权重加载就需要消耗近14GB显存,这在电池供电、整机功耗必须严格限制在10瓦乃至5瓦以内的嵌入式边缘硬件平台上无异于不可逾越的天堑。
尽管INT8与INT4量化在过去两年的边缘落地中发挥了重要作用,但当模型量化位宽进一步下潜至2-bit以下时,传统的均匀量化方案必然引发严重的精度崩溃。以三值网络(Ternary Quantization, {-1, 0, 1})为核心的1.58-bit极低比特技术,不仅从信息论底层打破了参数位宽极限,更通过从根本上淘汰浮点乘法运算,掀起了一场席卷底层芯片ALU微架构与嵌入式系统设计的深刻革命。
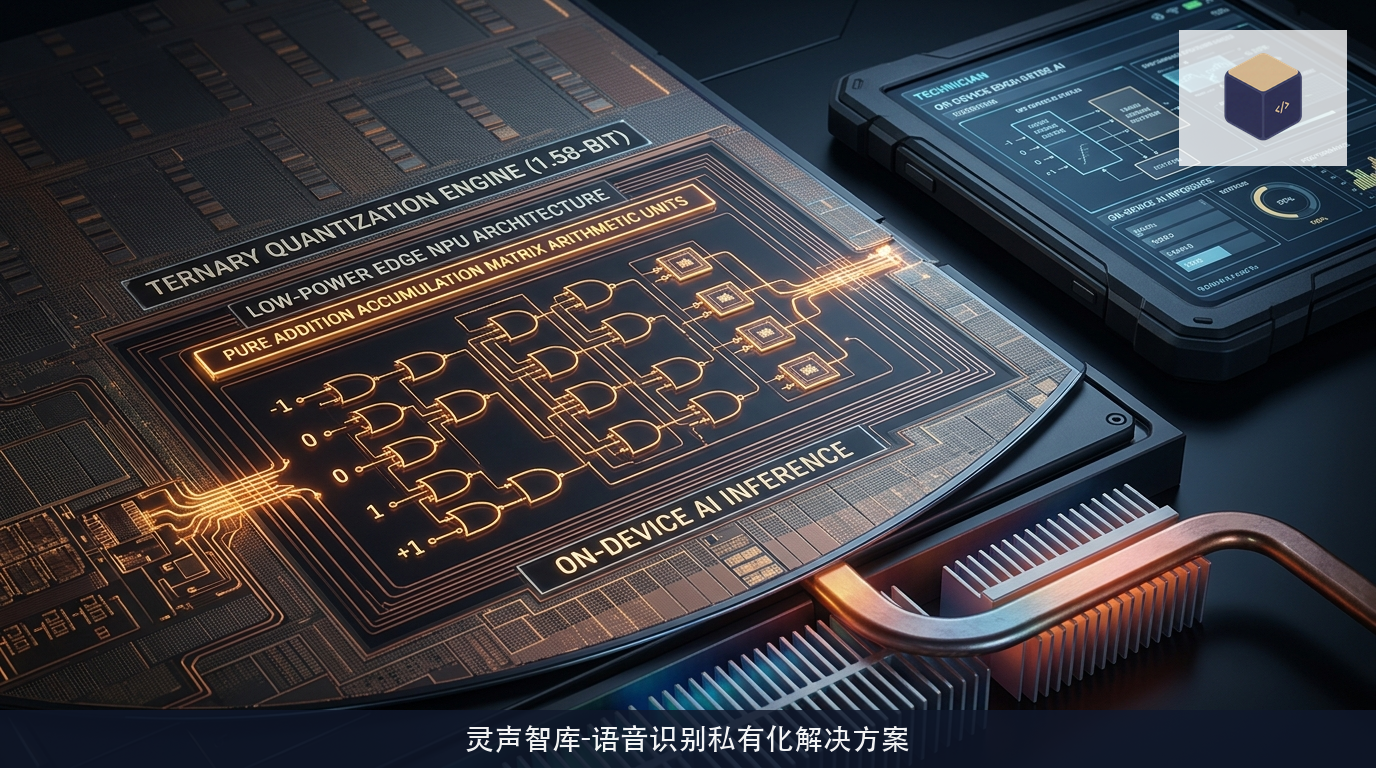
三值量化消除浮点乘法的代数逻辑与硅片能耗革命
理解1.58-bit量化的技术内核,首先需要明晰其命名的信息论渊源。在传统二进制计算机体系中,单个比特只能存储两种状态(0与1);若要在一个存储单元中无歧义地表达三元状态(-1, 0, 1),理论所需的最小信息熵为log2(3)约等于1.58比特。因此,全三值权重网络在学术与产业前沿被普遍定名为1.58-bit架构。
这种三值权重的引入,对深度学习最基础的计算算子——通用矩阵乘法(GEMM)实施了颠覆性的改造:
在标准浮点或整型量化神经网络中,前向推演的核心是乘累加(MAC)单元,硬件需要分配大量的晶体管面积与动态功耗用于计算高精度的尾数相乘与指数对齐;
而当大模型的权重矩阵被严格限制在{-1, 0, 1}的三值离散集合中时,权重与激活值(通常保持INT8精度)之间的代数运算发生了根本性的蜕变:
当权重为1时,计算等价于直接读取激活值原码并送入累加器执行加法;
当权重为-1时,计算等价于读取激活值的相反数补码并送入累加器执行减法;
当权重为0时,计算单元直接旁路跳过该操作,不产生任何算术运算与片上寄存器翻转;
这意味着,在整个庞大的前馈计算流中,曾经最为昂贵、耗电且发热严重的矩阵乘法器阵列被彻底剔除,取而代之的是极致精炼的纯定点加减法器阵列。在同等半导体工艺节点下,这种算子级的简化能够将芯片算术逻辑单元(ALU)的硅片面积缩减60%以上,同时将动态计算功耗剧降至传统乘法架构的不到十五分之一。
边缘访存带宽墙瓦解与片上SRAM驻留极限压榨
在低功耗边缘嵌入式计算中,决定自回归生成速度的根本瓶颈从不是单纯的算力峰值(FLOPS),而是极其严酷的片外内存访问带宽(Memory Bandwidth)。
大模型的自回归解码生成呈现出极其典型的内存受限(Memory-bound)特征。在生成每一个新的Token时,系统必须将整个模型的数十亿参数从片外动态随机存取内存(LPDDR5)完整加载搬运至片上高速缓存(SRAM)一次。在5瓦至10瓦功耗预算的嵌入式SoC平台上,内存总线物理带宽通常受限在30GB/s至60GB/s的低位:
运行传统的FP16模型时,巨大的权重搬运量会迅速吃满总线带宽,导致推理速度被死死卡在每秒个位数的卡顿状态;
而在采用1.58-bit三值量化后,模型权重体积经历了接近十倍的物理缩水。一个参数量达百亿规模的基座模型,在经过紧凑三值编码后,仅需不到2GB的物理内存空间即可完整载入:
这意味着端侧NPU在每一次代币生成循环中,需要从片外DRAM读取的数据量剧减80%以上,内存带宽瓶颈被彻底粉碎,使嵌入式芯片在极低功耗下爆发出每秒数十字的流畅生成速度;
更为深远的工程收益在于,由于模型总尺寸被大幅压缩,架构师得以将关键层的高频权重直接固化在NPU片上的大容量SRAM甚至新型非易失性MRAM中,从物理链路上杜绝了跨芯片总线数据搬移所引发的高额发热与能耗。
脱网工业环境下的被动散热与底层算子适配实测
将三值极低比特大模型真正集成至严苛的工业作业现场,必须解决工程落地的散热与框架适配挑战。
在煤矿瓦斯监测、化工防爆车间以及野外高温巡检等特种工业现场,便携式巡检手持机严禁加装任何机械风扇或主动散热孔,整机必须采用全封闭式镁铝合金机壳执行纯自然被动导热。在环境温度攀升至40摄氏度以上的极端夏日工况下,设备外壳温度必须严格被限制在工业安全红线(通常不超过55摄氏度)以内,否则将触发硬件强制降频甚至热保护关机。
一线工程部署团队针对端侧NPU开展了深度的底层算子优化重构:
主流推理框架往往缺乏对三值权重的硬件原生位支持,在推理前通常需要将压缩的三值位临时解包还原为INT8,这不仅未能节省访存带宽,反而凭空增加了频繁的格式解压系统开销;
工程师针对嵌入式NPU的SIMD向量指令集,研发了原地执行的三值紧凑位打包(Bit-packing)与加减原语算子。系统通过精巧的位掩码与移位操作,将单个字节内的4组三值权重直接映射为两条并行的加减指令,实现了零解包损耗的纯定点累加;
实测基准数据显示,在配备专用低功耗NPU的防爆手持平板上连续满负荷运行三值多任务模型3小时,整机功耗稳定收敛在5.8瓦,设备外壳最高温升严格控制在12摄氏度以内,彻底告别了过热死机与卡顿降频的顾虑。这种高能效、零网络依赖的纯边缘离线推理能力,正在为各关键行业数字装备的智能化转型构筑起坚实可靠的底层基石。