把单声道录音丢进开源转写工具,字大概能认全,一旦要区分“哪句话是谁说的”,现场往往就开始乱套:甲刚说完半句、乙插了一句“对,我补充两点”,整段文字全被归到了甲名下;或者两个人嗓音都偏低沉,聊到后半程系统干脆把两个人合并成同一个编号。做过公检法笔录自动转写或审讯谈话记录的工程师都知道,角色一旦张冠李戴,整份笔录核对返工的时间比人工重听一遍还要长。
先把实情摊开说:如果谈话现场座位固定、预算允许布设多支独立指向性鹅颈麦,直接走物理多通道硬件隔离,稳定度远胜任何单通道算法,完全没必要在软件层死磕盲源切分。只有在既有单路拾音设备无法改造、移动执法仪单麦录音或者历史归档音频整理的场景下,才需要靠本地部署的说话人分离与声纹识别管线硬啃这块骨头。
为什么开源默认管线一遇短插话就容易串角色
目前社区里应用很广的开源方案是 pyannote.audio 3.1,它把早期版本里容易卡环境的第三方编译依赖清理掉了,全流程跑在原生 PyTorch 上,后来 Rev 团队放出的 Reverb Diarization V2 也是在这套骨架上换用 WavLM 特征做深层调优。整条管线拆开看其实是三步接力:先用帧级分割网络找出哪里有人声、哪里存在两人抢话重叠;再按固定滑动窗口截取一到两秒的语音片段,送进特征提取器算出说话人嵌入向量;收尾阶段靠层次聚类或谱聚类把相似向量归进同一个角色桶里。
问题恰恰出在第二步和第三步的衔接上。提取音色特征的网络,不管是经典的 ResNet 结构,还是阿里 3D-Speaker、WeNet 社区 WeSpeaker 里常用的 CAM++ 与 ERes2Net,都需要攒够一定时长的元音共振峰,算出来的百维向量才足够稳定。当谈话里频繁出现零点五秒以内的短促回应,比如“没错”“是这样”“那天下午”,窗口里有效发声帧太少,抽出来的特征向量会往均值空间漂移,余弦距离瞬间失真。
除此之外,时间戳对齐环节还藏着一个细节坑:语音活动检测切出来的句子起止边界,跟分割网络输出的说话人跳变点往往差着一两百毫秒。许多脚本直接按起止时刻求交集硬切,如果前后缓冲边际留得太窄,句首的发声辅音容易被切进前一位发言人的尾巴里;缓冲边际留得太宽,又会把对方刚开口的半个字吞进来。
更头疼的是无监督聚类的固有盲区。当整场谈话长达一小时,某位当事人前二十分钟情绪平稳,后二十分钟语速加快、嗓音沙哑,单纯依赖谱聚类很容易把同一个人拆成“说话人A”和“说话人C”;反过来,如果两位男性谈话人基频接近,录音室混响又把高频齿音抹平了,聚类阈值稍微设宽一点,两边就会被硬捏成同一个人。
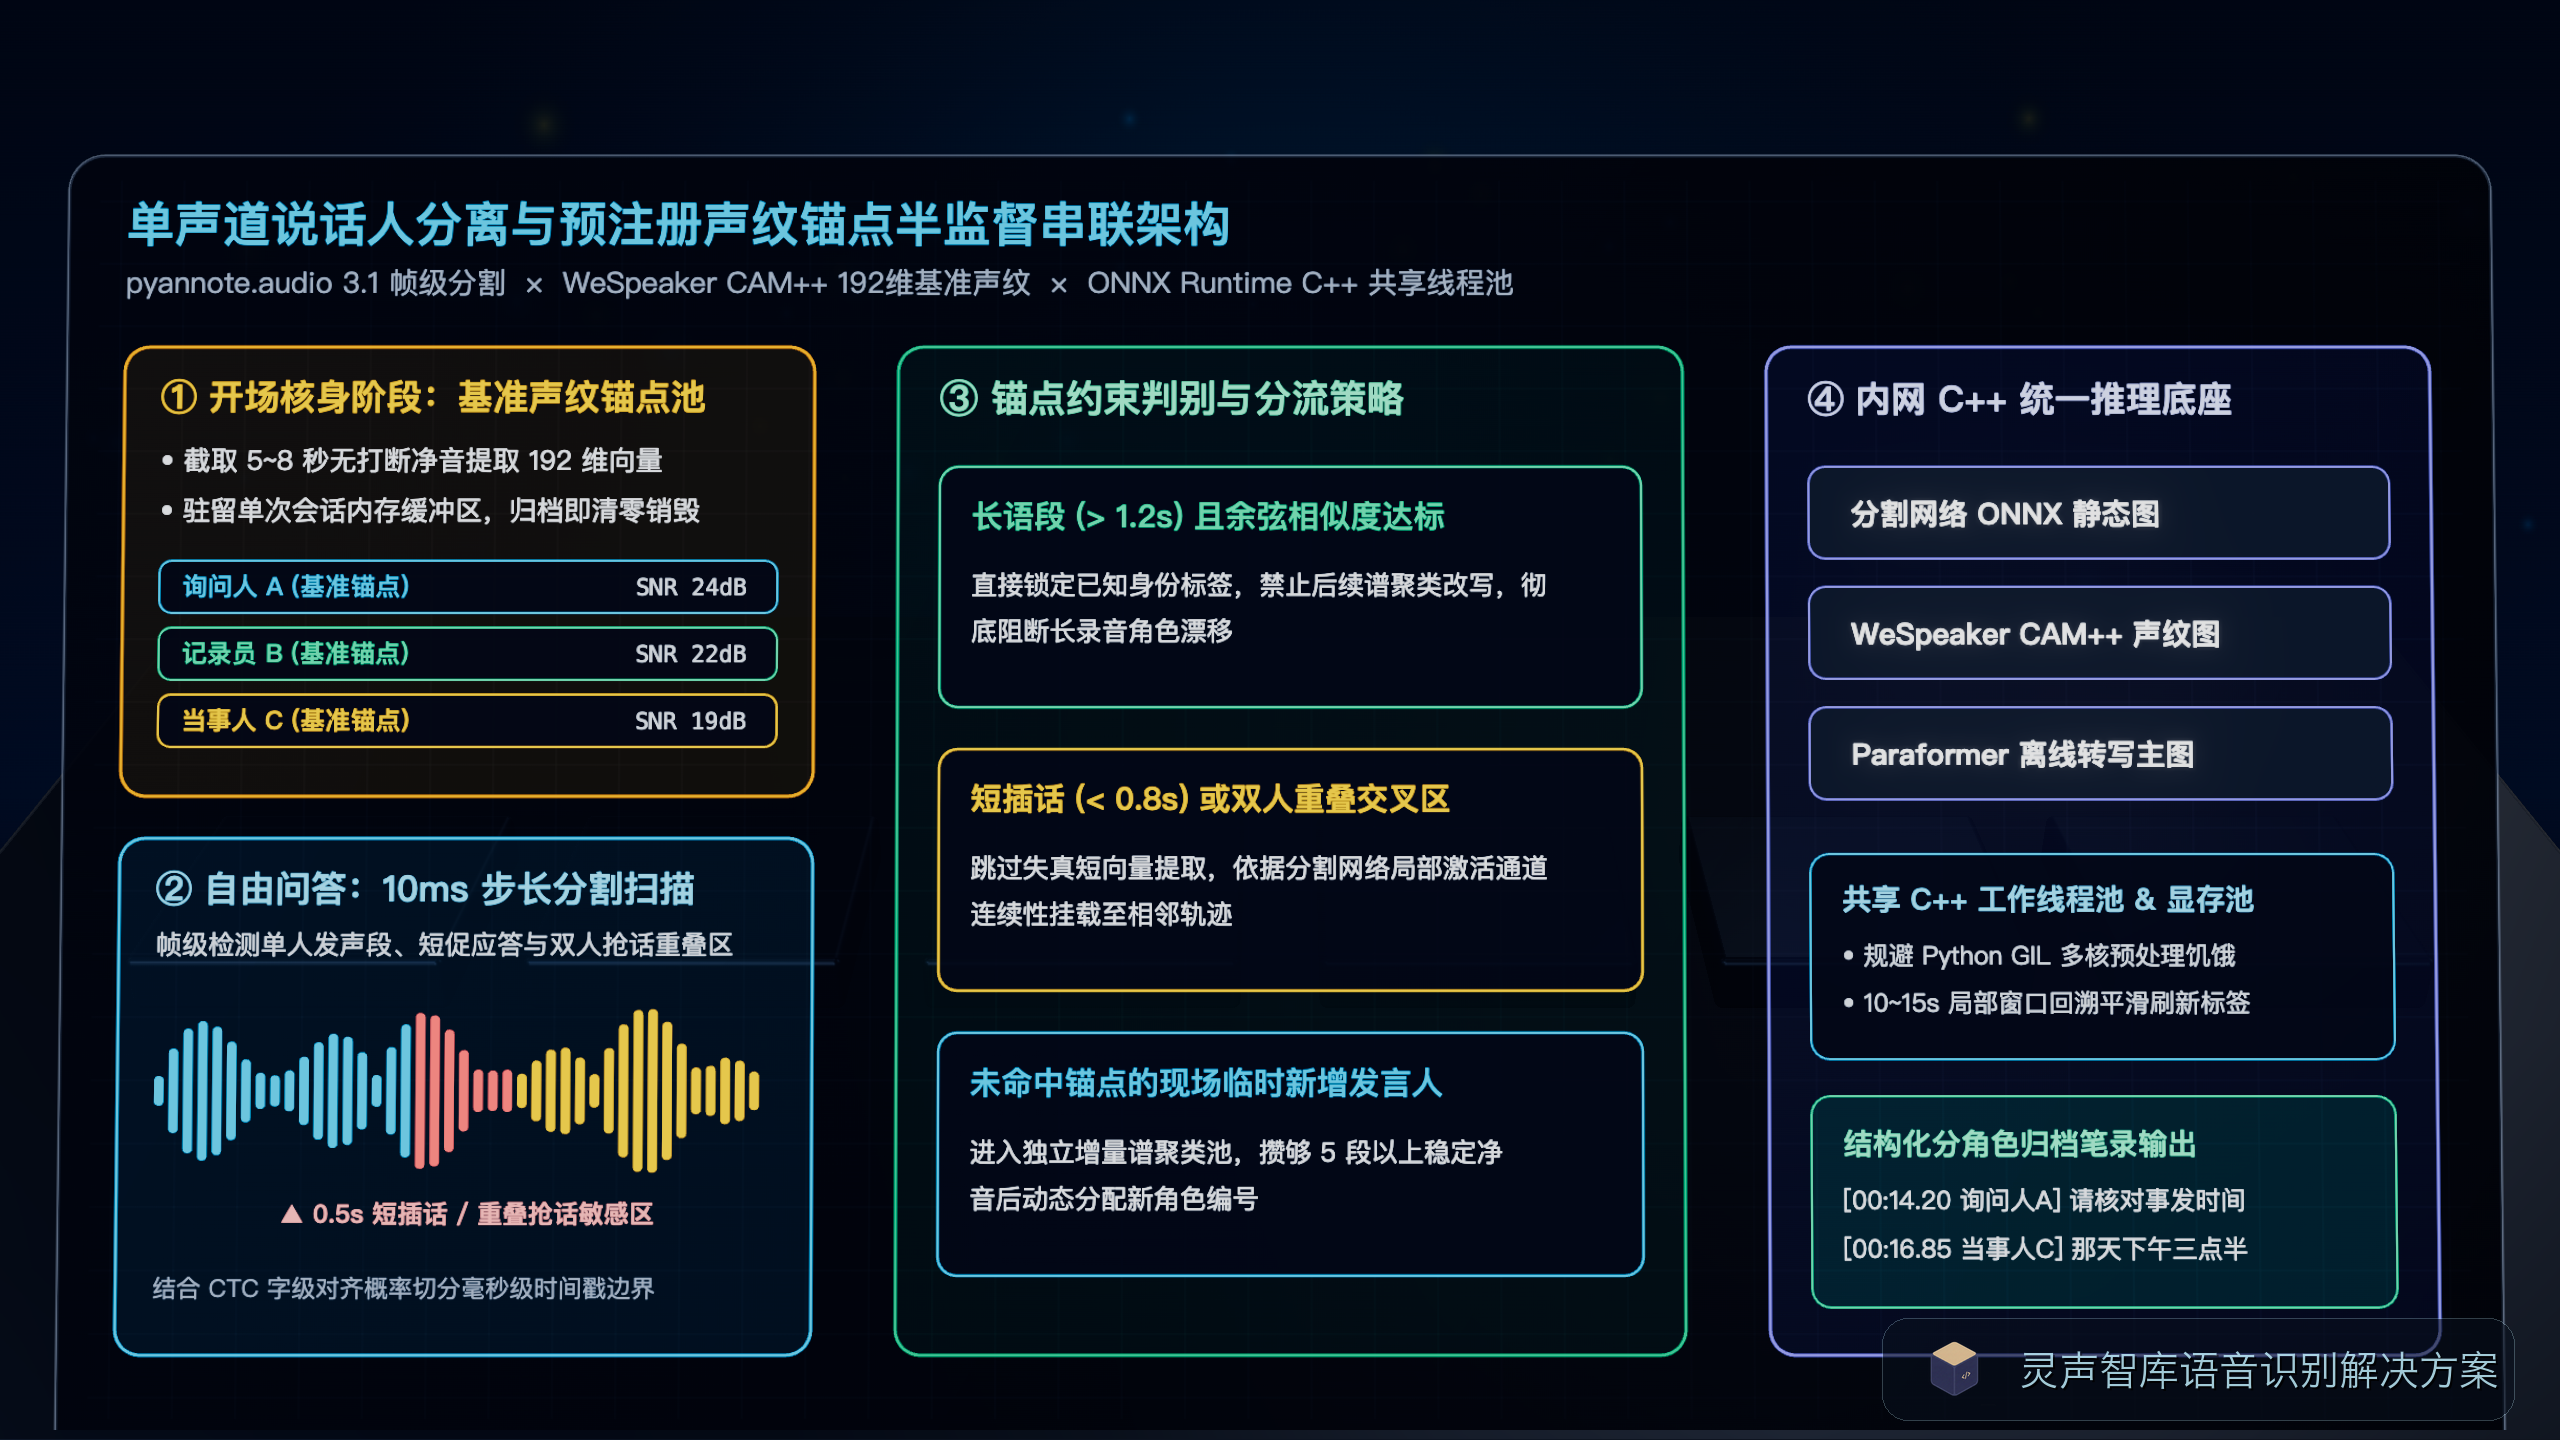
把预注册声纹锚点塞进聚类环路怎么改
要治住长录音里的角色漂移,工程上行之有效的办法是把“盲聚类”改成“带锚点的半监督约束聚类”,也就是把声纹识别前置到说话人分离的归并阶段里。
具体落地时,不需要改动离线语音转写底层的声学权重。在正式笔录或例会开始前,通常都有核对身份的固定环节,比如询问姓名、职务或宣读告知书。每个人在这一阶段都会留下一段五到八秒、没有他人打断的干净语音。本地引擎先调用 WeSpeaker 导出的 CAM++ ONNX 模型,为在场已知人员各生成一条高信噪比基准声纹向量,锁进当前会话的内存池里。
等进入自由问答环节,pyannote 的分割模块照常以十毫秒级步长扫描音轨,把切出来的纯净单人语段先跟内存池里的基准声纹做余弦相似度比对。凡是时长超过一点二秒、且与某个已知锚点相似度高于设定门限的片段,直接锁定身份标签,禁止后续聚类器改写;对于低于零点八秒的极短插话,或者两人重叠开口的交叉区,则不再强行单独提取噪声偏大的短向量,而是结合分割网络输出的局部激活通道连续性,优先挂载到相邻帧已激活的声道轨迹上,并把字级时间戳利用 CTC 帧对齐概率精确切开。
如果现场存在未提前留声的临时发言人,未命中任何已知锚点的游离向量会单独进入增量谱聚类池,攒够五段以上稳定语音后再动态分配新编号。翻看灵声智库过往整理的室内远场实测记录也能看到类似规律:在双路本地服务器上用这套半监督串联逻辑处理一小时以上的交替问话,相比直接拿默认参数硬跑盲聚类,后半程角色合并错误与莫名多出来的幽灵角色编号能压下去一大截,人工校对基本只需抽查抢话重叠处。
迁往内网 C++ 运行时与算力占用的真实账本
在开发机上用 Python 跑通 pyannote 加 FunASR 只是验证原型的起步动作,真做 ASR本地部署交付到政法专网或企业机房时,直接拿原生 PyTorch 脚本起服务多半会栽在并发和内存碎片上。
分割模型、CAM++ 声纹模型加上后端的离线语音转写主模型,三套权重如果各自独立维护一套推理上下文,进程常驻显存和主机内存开销相当可观,且 Python 全局解释器锁在多路音频切片并行做梅尔频谱预处理时会把单核打满、其余核心闲置。比较稳妥的工程路线是借助 sherpa-onnx 或 ONNX Runtime C++ 接口,把分割网络、WeSpeaker 声纹提取器以及 Paraformer 转写模型统一导出为静态图或带分档动态轴的 ONNX 模型,共用同一个工作线程池管理音频重采样与特征提取。一张常规十六吉显存的推理卡,在半精度下能稳稳承接十余路并发谈话室的实时切分与转写。
有一笔硬件账在立项前得算明白:带重叠检测的说话人分离并不是毫厘不差的即时操作。因为聚类算法需要观察前后若干个语段的分布才能拍板归属,实时上屏往往只能先按局部声纹比对给个暂定角色名,每隔十到十五秒再由后台局部窗口重聚类做一次回溯修正。前端界面设计必须预留角色标签平滑刷新的交互机制,如果业务方硬性要求字刚跳出来那一百毫秒内角色归属就彻底锁死不许变,单麦算法目前做不到,老老实实上多麦分轨硬件才是正道。
此外,在涉及未成年人询问或涉密审讯的封闭机房中,提前提取的基准声纹特征属于高敏感生物识别信息。工程实现上切记只将声纹向量驻留在单次会话内存缓冲区内,笔录归档落盘后立即清零销毁内存锚点,不在磁盘数据库里跨案件留存原始声纹模板,既省掉长年累月的模板库维护包袱,也能干净利落地守住个人信息合规边界。