把一套在通用新闻语料上准确率很高的离线语音转写引擎直接搬进医院诊室或地方农商行网点,往往不出三天就会收到一堆一线人员的吐槽:呼吸科医生口述病历里的“阿奇霉素干混悬剂”“支气管舒张试验”,转出来全是八竿子打不着的日常同音字;柜员用带川渝或闽南口音的普通话向老人做风险提示,平翘舌和前后鼻音一混,后台金融柜台质检规则引擎立刻误报“漏读关键合规条款”。
遇到这类垂直业务水土不服,很多项目组要么指望客户自己一个个手工改错字,要么病急乱投医,想着花几十万买卡从头重训一个行业底模。其实做行业级 ASR本地部署真没必要走这两个极端:把音素级热词图谱、几十小时的轻量口音适配器微调,以及下游本地 RAG知识库语义分析这三板斧配合好,花小钱一样能把专业术语和地方口音啃下来。
热词权重不是调得越高越灵,小心“劫持”日常口语
主流的开源转写框架,像 FunASR 里的 Contextual Paraformer 或者基于加权有限状态转换器的 WeNet 解码器,都原生提供了热词偏置接口。原理并不玄乎:在解码搜索生成候选词路径时,只要某条路径匹配上预设词表里的药名或理财产品名,就给它的得分额外加上一笔奖励分,帮它在同音词竞争里胜出;即便识别途中前两个音节没追上,偏置自动机里的回退弧也能及时回收前缀奖励,避免整句分数乱套。
可一到真刀真枪配词表的时候,坑就来了。医院药房目录和检查项目动辄四五千条,不少工程师一股脑儿全塞进热词文件,还把激励权重设得老高。结果药名倒是认出来了,医生随口嘱咐患者一句日常白话,但凡发音跟某个生僻药名沾点边,立马被高权重强行“劫持”替换成药名,整份病历读起来哭笑不得。
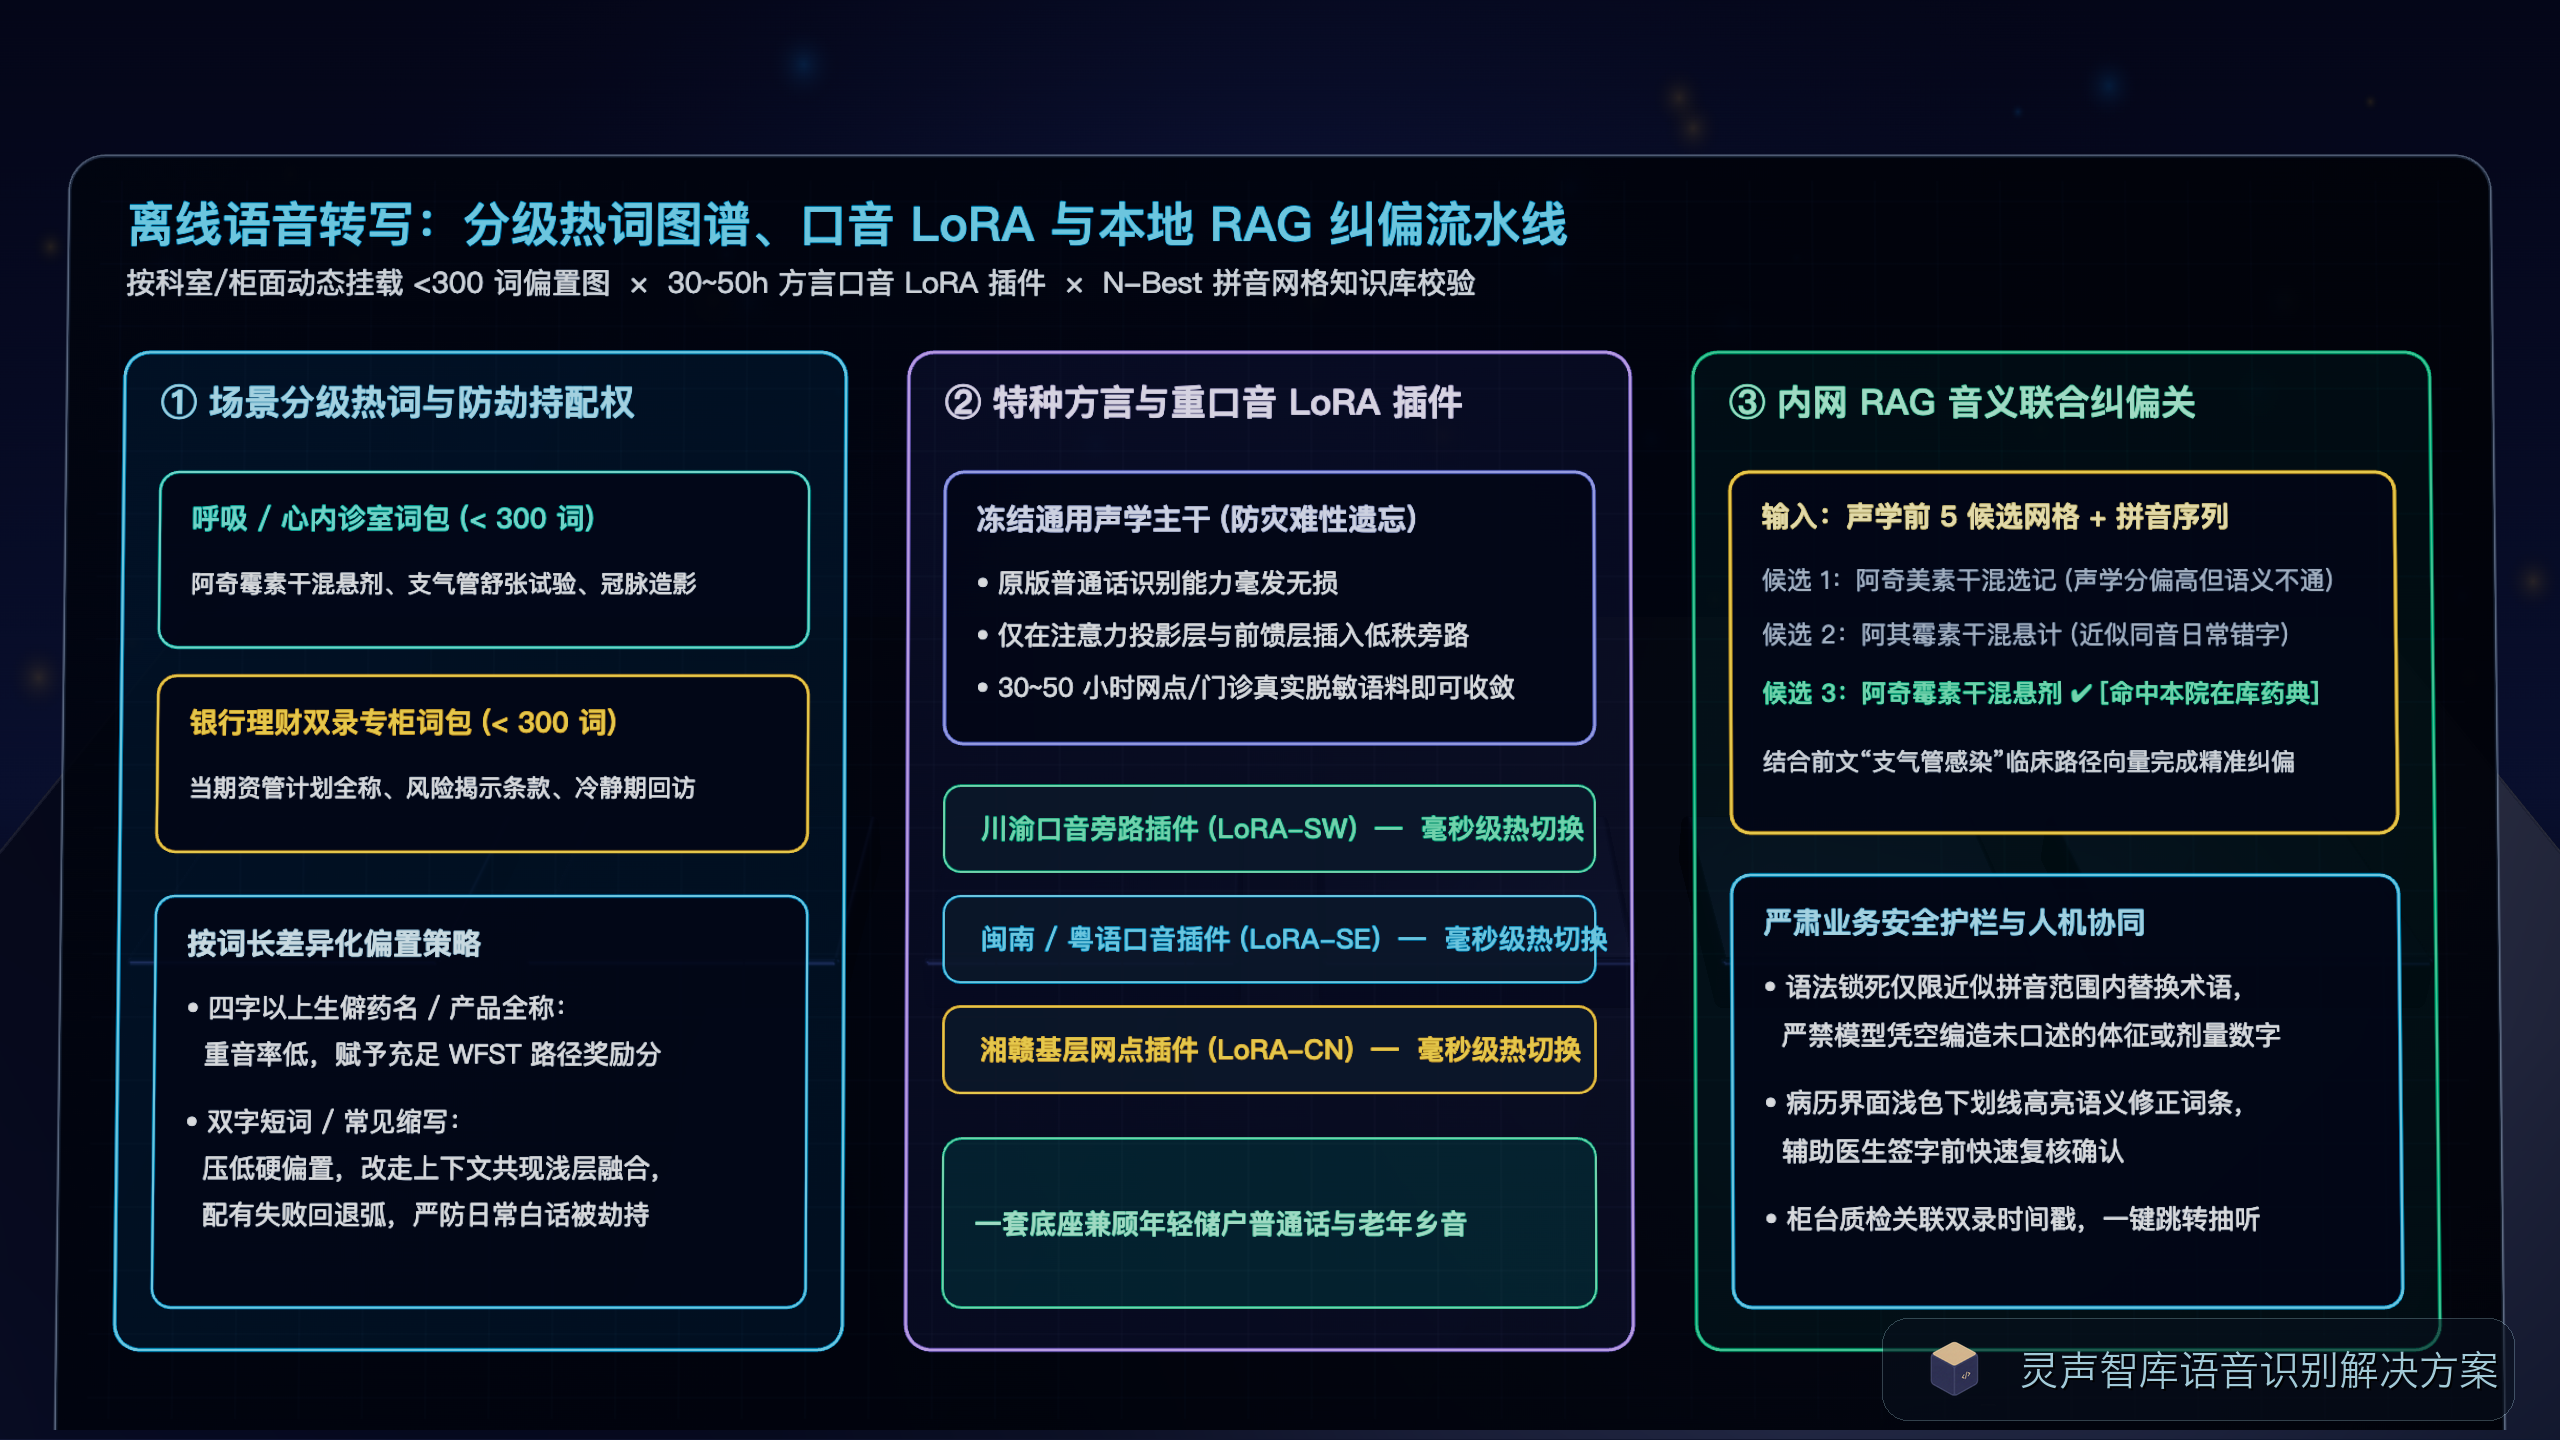
要想热词既管用又不添乱,得做精细的分级与音素裁剪。头一件事是别把整本字典全挂在全局会话上,而是跟着医生登录的科室工号或柜员所在的业务窗口动态挂载专属小词表:心内科诊室只加载心血管常用药名、介入耗材与检查词包,银行理财专柜只加载当期在售资管产品名称与双录合规必读词包,把单次会话激活的热词规模严格控制在三百条以内,解码搜索空间与命中精度立刻清爽不少。再就是激励分值要按词长与音素区分度差异化配置:四个字以上的化学药名或信托计划全称重音概率低,偏置奖励分给高些无妨;两个字的短词或常见英文缩写极易跟日常口语动词撞音,必须压低偏置权重,或者改为结合前后词共现概率的浅层语言模型融合打分,防止正常对话被误伤。
治重口音和特种方言识别别动不动全量重训
热词偏置能救标准发音下的生僻词,却救不了发音本身就已经跑偏的重口音。在县域政务大厅、基层农商行或者方言区门诊里,办事群众和老年患者说的是夹杂本地俚语的“椒盐普通话”,声母舌位和韵母归并规律跟标准普通话差异很大,底模在声学层就已经算歪了音素概率,后面怎么调词表都白搭。哪怕把方言区常混淆的前后鼻音、平翘舌做成模糊音映射塞进词图,一旦扩得太宽,又会引入成倍的同音歧义。
做特种方言识别适配时,千万别一上来就动全量参数微调。一旦拿几十个小时的方言录音把整个声学编码器全量刷一遍,灾难性遗忘马上找上门:当地口音是准了一点,换个讲标准普通话的年轻储户过来,识别率反而哗哗往下掉。
现在工程界省力又稳妥的办法是冻结原版基座模型的绝大多数参数,只在声学编码器的注意力投影层与前馈层旁路插入低秩适配器模块,也就是大家熟知的 LoRA 微调。实操下来,只需要从目标网点或诊室真实脱敏录音里挑出三十到五十小时有代表性的重口音语料,花半天工夫由熟悉当地话的业务员校对出准确标注文本,在单张消费级或推理级显卡上训几个轮次就能收敛。上线运行时,既可以按网点地域加载对应的轻量口音插件,也可以保留主干共享、由前置轻量口音分类器在毫秒间动态切换旁路权重,一套底座就能兼顾标准普通话与各路地方口音。
用本地 RAG知识库语义分析把好同音纠错关
即便加了分级热词和口音微调,碰到口齿含糊的快速连读,单靠声学解码取榜首候选句仍然难免漏网。这时候与其继续跟声学层死磕,不如把前五条候选网格连同拼音序列一起往后递一步,交给内网部署的 RAG知识库语义分析模块做二次把关。
举个医疗病历语音输入的实际例子:假设声学引擎对某段含糊发音给出了前三个近似音候选,排在榜首的是个不通顺的日常词组,排在第三位的恰好与本院药房在库药品目录里的某款处方药同音,且前文刚提到对应的适应症症状。本地七十亿参数级别的轻量量化语言模型结合向量检索出来的院内药品知识库与临床路径规范,一眼就能判断出第三条候选才符合诊疗上下文,顺手完成纠偏并按标准病历字段格式化填入系统,还在前端界面用浅色下划线标出经过语义修正的词条,提醒接诊医生签字前扫一眼确认。需要注意严控生成约束,在提示词与解码语法上锁死只准基于声学拼音近似范围替换专有名词,严禁语言模型凭空脑补患者没说过的阳性体征或剂量数字。
在金融柜台质检场景里也是同样的道理:参考灵声智库在合规双录质检场景下的实测做法,不拿带错别字的粗转写文本直接去撞死板的关键词正则,而是先对照当期理财合规话术向量库做音义联合对齐,分清柜员到底是真漏念了风险揭示条款,还是因为乡音把某个字咬偏了音,并把对齐后的证据时间戳直接关联到双录音视频切片上方便复核人员一键跳转抽听。把声学认字、口音适配和业务知识库校验串成一条互相兜底的本地流水线,离线转写才算真正在严肃业务现场站稳了脚跟。