很多算法团队在英伟达显卡上把开源语音模型调得顺风顺水,满以为做信创ASR部署无非是把 PyTorch 权重导成 ONNX、再换个推理后端重新编译一遍。真等机器拉进客户机房,插上华为昇腾 310P 加速卡或者海光深算 DCU,配好麒麟操作系统和鲲鹏多核处理器,跑起初批真实业务录音时,一连串意想不到的怪毛病就会接踵而至:要么一句话算完耗时比普通处理器还慢,要么遇到嗓门大的录音直接吐出一串乱码和空值。
先把结论摆在前面:如果项目本身没有硬性的国产化目录准入要求,并发量也就三五路,直接用成熟的主流处理器跑模型量化加速后的 ONNX Runtime 往往省心又划算,犯不着为了追时髦硬啃异构编译链。一旦进入政务内网、金融机构或大型国企机房改造,必须完成实打实的国产GPU适配与 ASR本地部署时,下面这三道工程关卡几乎家家都得挨个过一遍。
变长音频遇上静态图编译为什么突然变慢
图像识别模型的输入尺寸通常是长宽固定的正方形张量,编译一次就能一直跑;离线语音转写却天生是个变长序列活儿,上一条录音只有两秒半,下一条可能是二十八秒的长句。在 CUDA 生态里,动态张量形状早已被运行时打磨得比较平顺;但迁往昇腾 CANN 软件栈并使用 ATC 工具把 ONNX 编译成离线模型文件时,如果图省事直接开启全范围任意动态维度,底层算子往往没法命中预调优的高效分块核函数,甚至会在部分不支持动态边界的规约算子上频繁退回主控处理器执行,来回搬运内存把延迟拖得惨不忍睹。
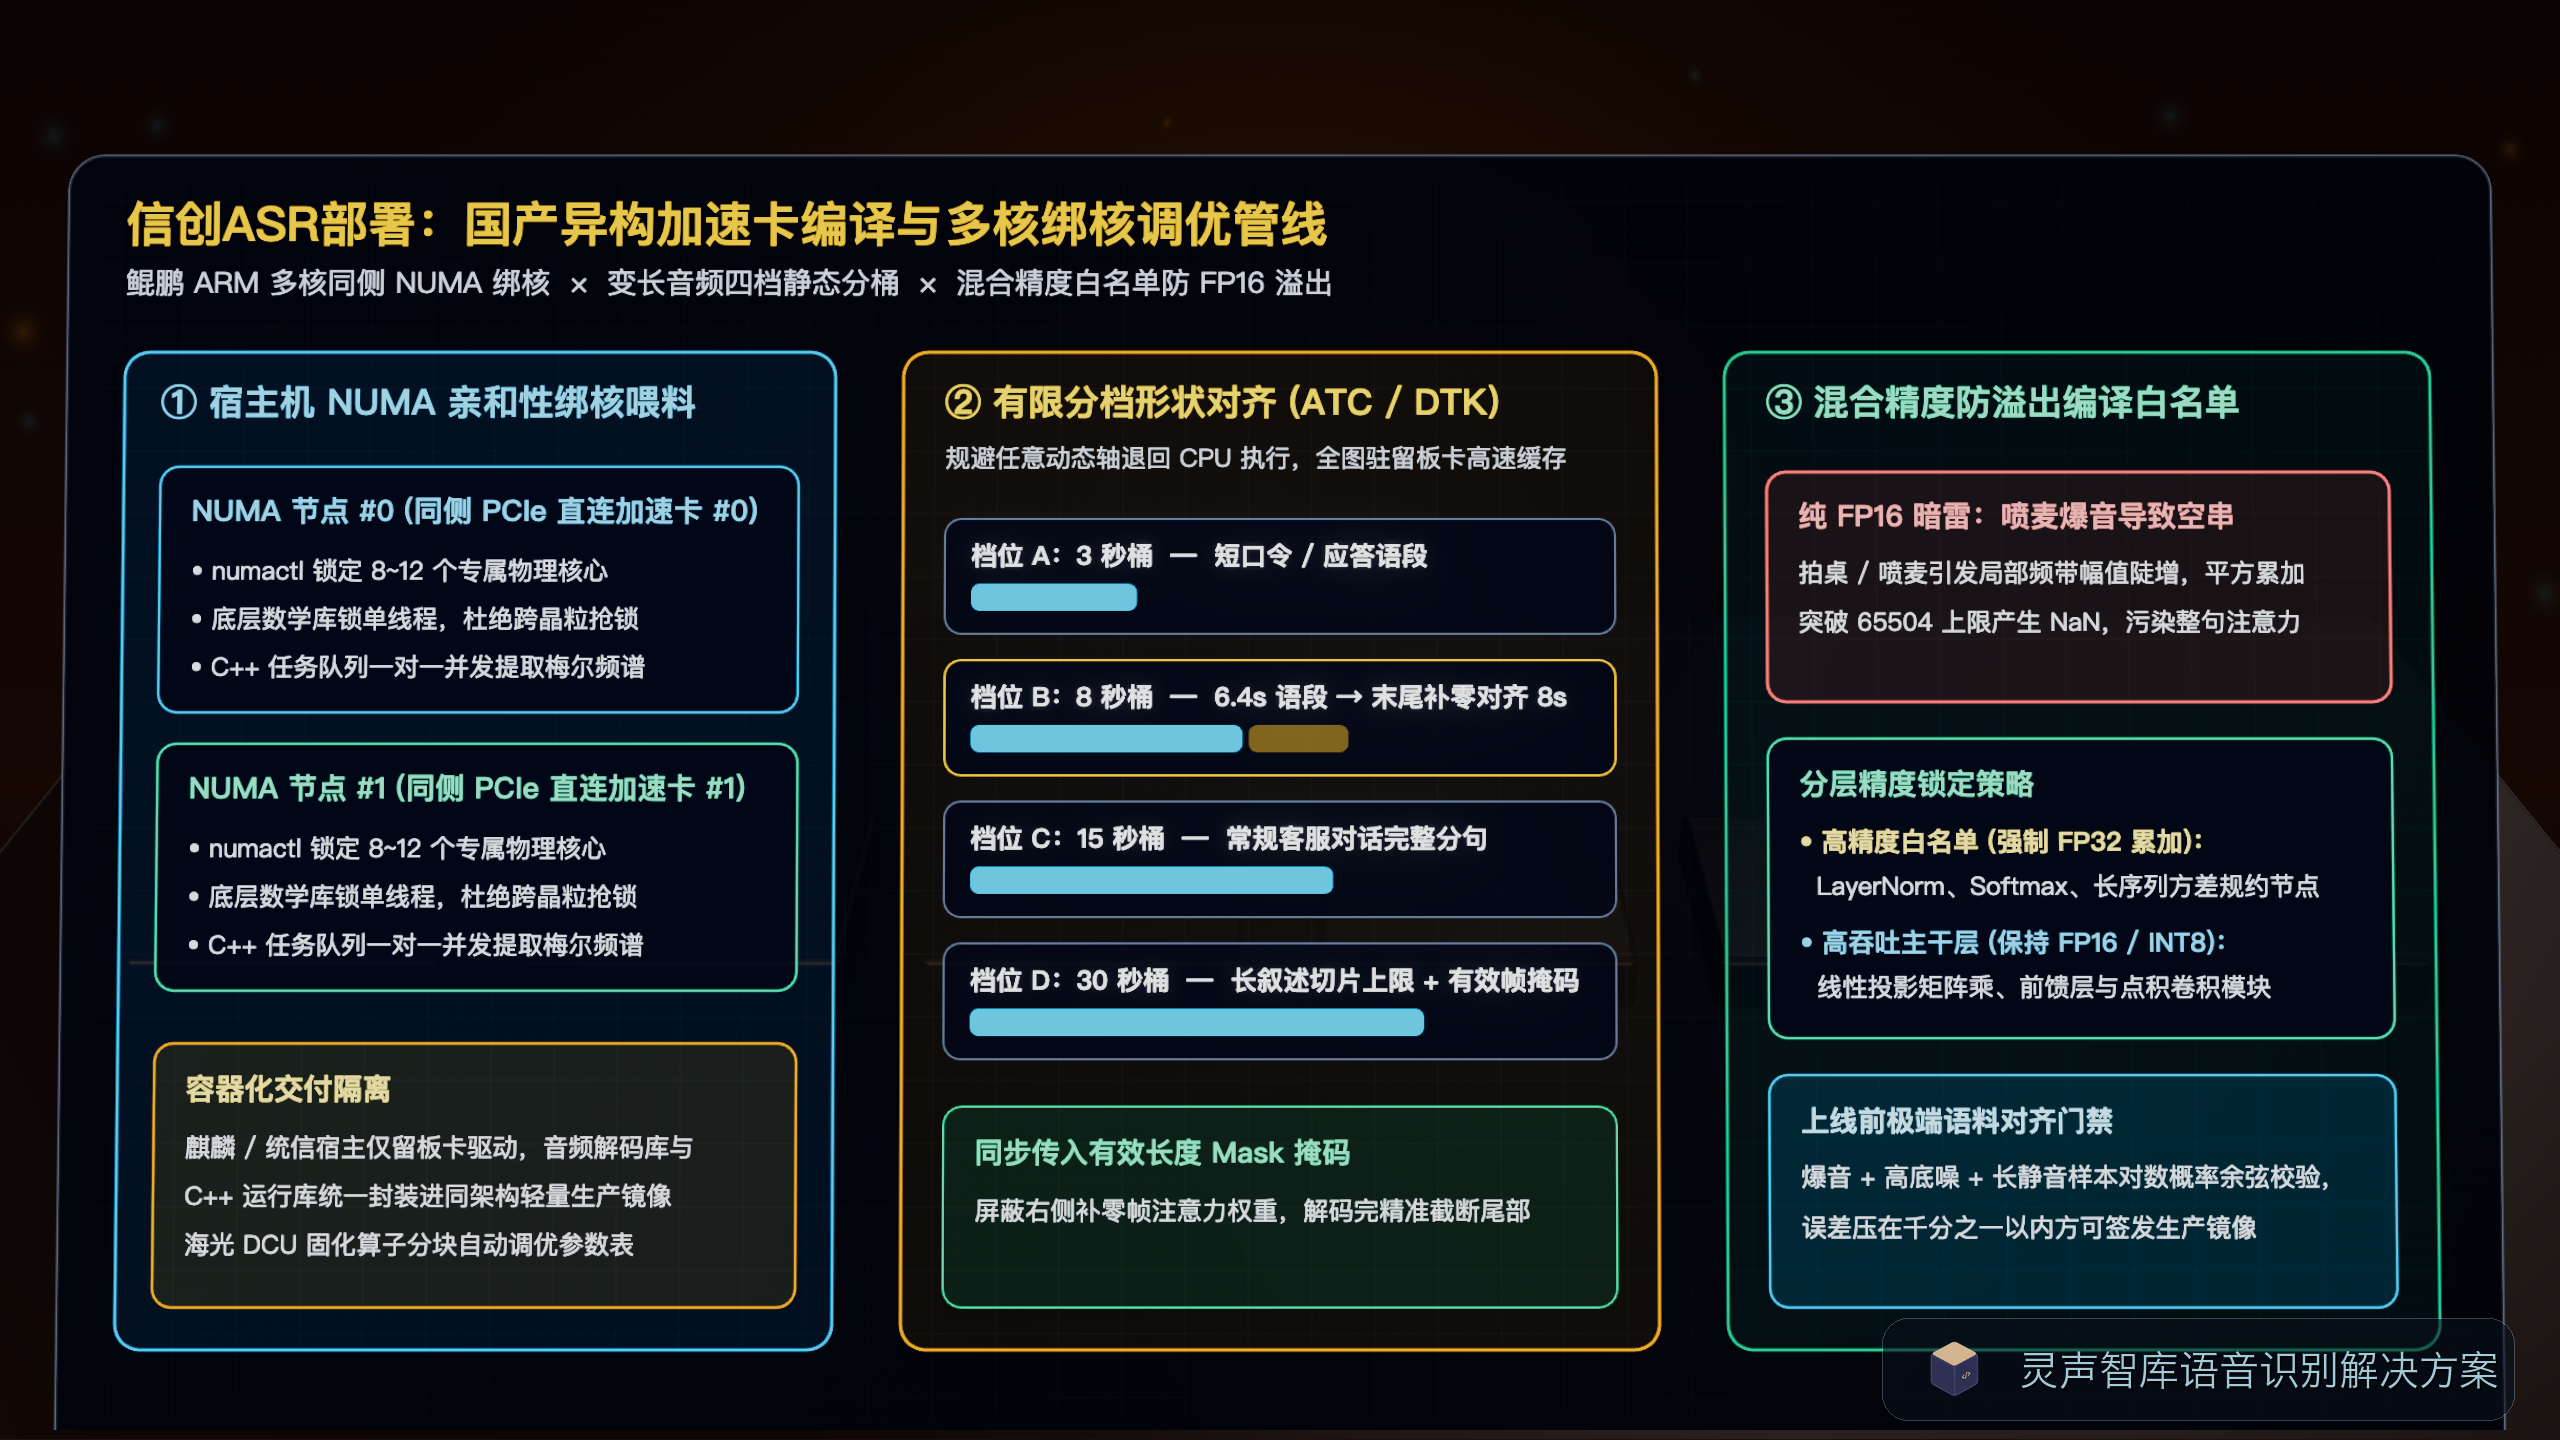
工程上管用的解法是“有限分档动态形状”加右侧零填充。我们通常会先统计业务真实语音切分后的长度分布,比如经过端点检测切开后,九成以上的语段集中在三秒、八秒、十五秒和三十秒以内。于是在离线图编译阶段明确声明这四个固定档位,运行时拿到一段六点四秒的梅尔频谱,直接在末尾补零对齐到八秒档位的张量尺寸送入板卡,并同步传入真实有效帧掩码防止补零区参与注意力权重分配,算完后再按有效长度截断尾部输出。虽然补零多花了一丁点矩阵计算量,但换来了全图算子留在加速卡高速缓存内一气呵成跑完,整卡吞吐反倒翻了好几番。
迁往海光深算 DCU 时则是另一番景象。海光的 DTK 软件栈采用类 CUDA 编程模型,对主流开源算子兼容性不错,导出迁移门槛低不少,但它的片上共享内存容量与显存读写带宽特性跟同档位显卡存在差异。直接照搬原有的矩阵乘分块配置容易遇到寄存器压力偏高、波前占用率下滑的问题,特别是长语音解码阶段的自注意力键值拼接操作,频繁触发小块显存重分配会把单句尾延迟拉高一倍。工程上需要针对声学编码器里的隐藏层维度重新跑一遍算子自动调优脚本,把调好的分块参数缓存文件打包固化到生产容器镜像里,启动服务时直接命中调优表,才能跑出板卡应有的标称吞吐。
半精度累加溢出引发的空结果怎么定位
第二个让人挠头的隐蔽故障是莫名其妙的识别空白。在实验室拿标准朗读测试集跑分一切正常,一接进柜面或热线录音,每隔几百条就会冒出几句完全认不出字的空串。
顺着中间层张量逐层转储比对就会发现,问题出在半精度浮点数的表示上限。不管是 Conformer 还是 Paraformer,声学编码器里都包含大量层归一化、卷积模块与多头注意力能量打分。当现场录音里突然混入拍桌子、麦克风喷麦或者刺耳电流声,局部频带的能量幅值会陡增;在昇腾达芬奇架构的矩阵计算单元上,默认转成 FP16 计算时,大数值平方求和很容易冲破六万五千五百零四的表示上限,瞬间变成无穷大,紧接着把整句的注意力分布全盘污染成非数值。
修复这颗暗雷不能靠一刀切回退到全量单精度,那样算力直接腰斩。正确的做法是在离线编译配置文件里启用混合精度保留策略,专门把编码器里的层归一化、指数归一化以及长序列方差累加节点列入高精度白名单,强制这些对数值范围敏感的算子走单精度浮点累加,而占算力大头的线性投影与点积层依然留在半精度或八比特整型通道里跑。参考灵声智库此前归纳的异构板卡精度对齐清单,上线前拿十条带爆音、高底噪和超长静音的极端测试音频跑一遍余弦相似度校验,把输出对数概率误差控制在千分之一以内,喷麦录音导致整句崩盘的现象基本就能断根。
别忽视鲲鹏多核宿主机上的前端预处理抢核
不少团队把全副精力都扑在加速卡算子适配上,上线压测时却发现加速卡有一半时间在空等,瓶颈竟然卡在了宿主机的音频前端预处理上。
信创服务器普遍搭载单路或双路多核 ARM 架构处理器,核心数动辄六十四核乃至一百二十八核,单核主频却不像桌面高频处理器那么激进,且芯片内部跨晶粒、跨非统一内存访问节点的延迟差距明显。如果多个离线语音转写工作进程任由操作系统跨节点随机漂移,再遇上底层数学库默认拉起几十个开放多线程去算短时傅里叶变换,大量处理器时间都会耗费在跨节点缓存同步与线程锁争抢上。
另外在操作系统软件源层面,银河麒麟或统信服务器版自带的基础音频解码库版本偏保守,直接在宿主机裸装动态库很容易跟加速卡驱动依赖的编译器运行库打架。老练的交付工程师都会把驱动层之外的运行环境封进架构对齐的轻量容器镜像,在启动命令里用 numactl 把进程核亲和性与加速卡挂载的总线节点严格绑在同一侧:每张加速卡固定配对同侧内存节点下的八到十二个物理核心,并把底层线性代数库的内部线程数锁成单线程,完全由上层 C++ 音频任务队列按核数一对一并发拉起特征提取。把宿主机与加速卡之间的喂料节奏理顺了,整套国产化离线转写底座才能在不挑食的前提下长年累月稳定扛住业务洪峰。