不少团队初次做 ASR本地部署压测时都会碰上一件怪事:单张二十四吉显存的推理卡,单路测试时延迟只有几十毫秒,可一旦用压测脚本并发灌进来八十路实时通话音频流,客户端就开始大面积报超时、吐字卡顿,打开监控一看,显卡计算核心利用率竟然还不到百分之三十五,显存也空着一大半。
明明算力没吃满,系统到底卡在哪儿了?直接说根因:流式高并发语音处理跟无状态的图片分类或单轮文本问答完全是两码事。每一路长连接每隔几百毫秒就推过来一小包音频,如果网关傻乎乎地来一包就往显卡里调一次推理核函数,整张卡的时间全浪费在每秒上千次的微小内核启动开销与主机到显存的零碎拷贝上了,真正的矩阵乘加单元反而一直在等投喂。
有状态流式编码器为何忌讳“散装”小包直通
要想把实时吐字延迟压在半秒以内,离线ASR引擎通常得跑流式分块架构,像工业界常用的流式 Paraformer、WeNet 的分块 Conformer 或者 sherpa-onnx 里的流式 Zipformer。这类模型的共同特点是“有状态”:当前这六百毫秒音频块送进去计算时,必须把同一通电话前几秒积攒下来的卷积层历史边界缓存、注意力键值缓存以及语音活动检测状态一并带进去,算完再把更新后的状态张量写回会话内存。
在开发原型阶段,很多工程师图省事,直接拿 Python 的异步协程框架包一层 WebSocket 服务,每条连接收满九千六百个采样点就调一次模型前向接口。十路并发以内这么干风平浪静;等到并发拉升到上百路,问题就全爆发了。一方面,百路音频挤在单个进程里跑短时傅里叶变换和梅尔滤波器组提取,纯靠解释器线程轮转根本喂不饱多核处理器;另一方面,每次只塞一条样本进显卡,张量形状极扁,硬件底层的张量核心连一个基本分块都填不满,算力空转率居高不下。
协议层的拆包细节同样容易埋雷。浏览器前端或软交换网关推过来的音频帧大小五花八门,有的每二十毫秒发一包三百二十字节的裸采样,有的攒够两百毫秒才发一包,甚至还夹杂八千赫兹窄带电话编码流。如果服务端不对每条会话维护独立的无锁环形字节缓冲区与重采样状态器,而是直接在网络读写回调里切帧提取频谱,光系统调用、采样率转换和内存切片拷贝就能白白吃掉好几个物理处理器核心。
更隐蔽的坑在于连接生命周期不一致。客服坐席或政务热线里,随时有通话挂断、随时有新电话呼入。如果状态张量分散在各自协程的堆内存里频繁申请与释放,跑上十几个小时就会触发显存分配器碎片化,冷不丁卡出一次几百毫秒的内存整理停顿,整批在线会话跟着集体抖动。
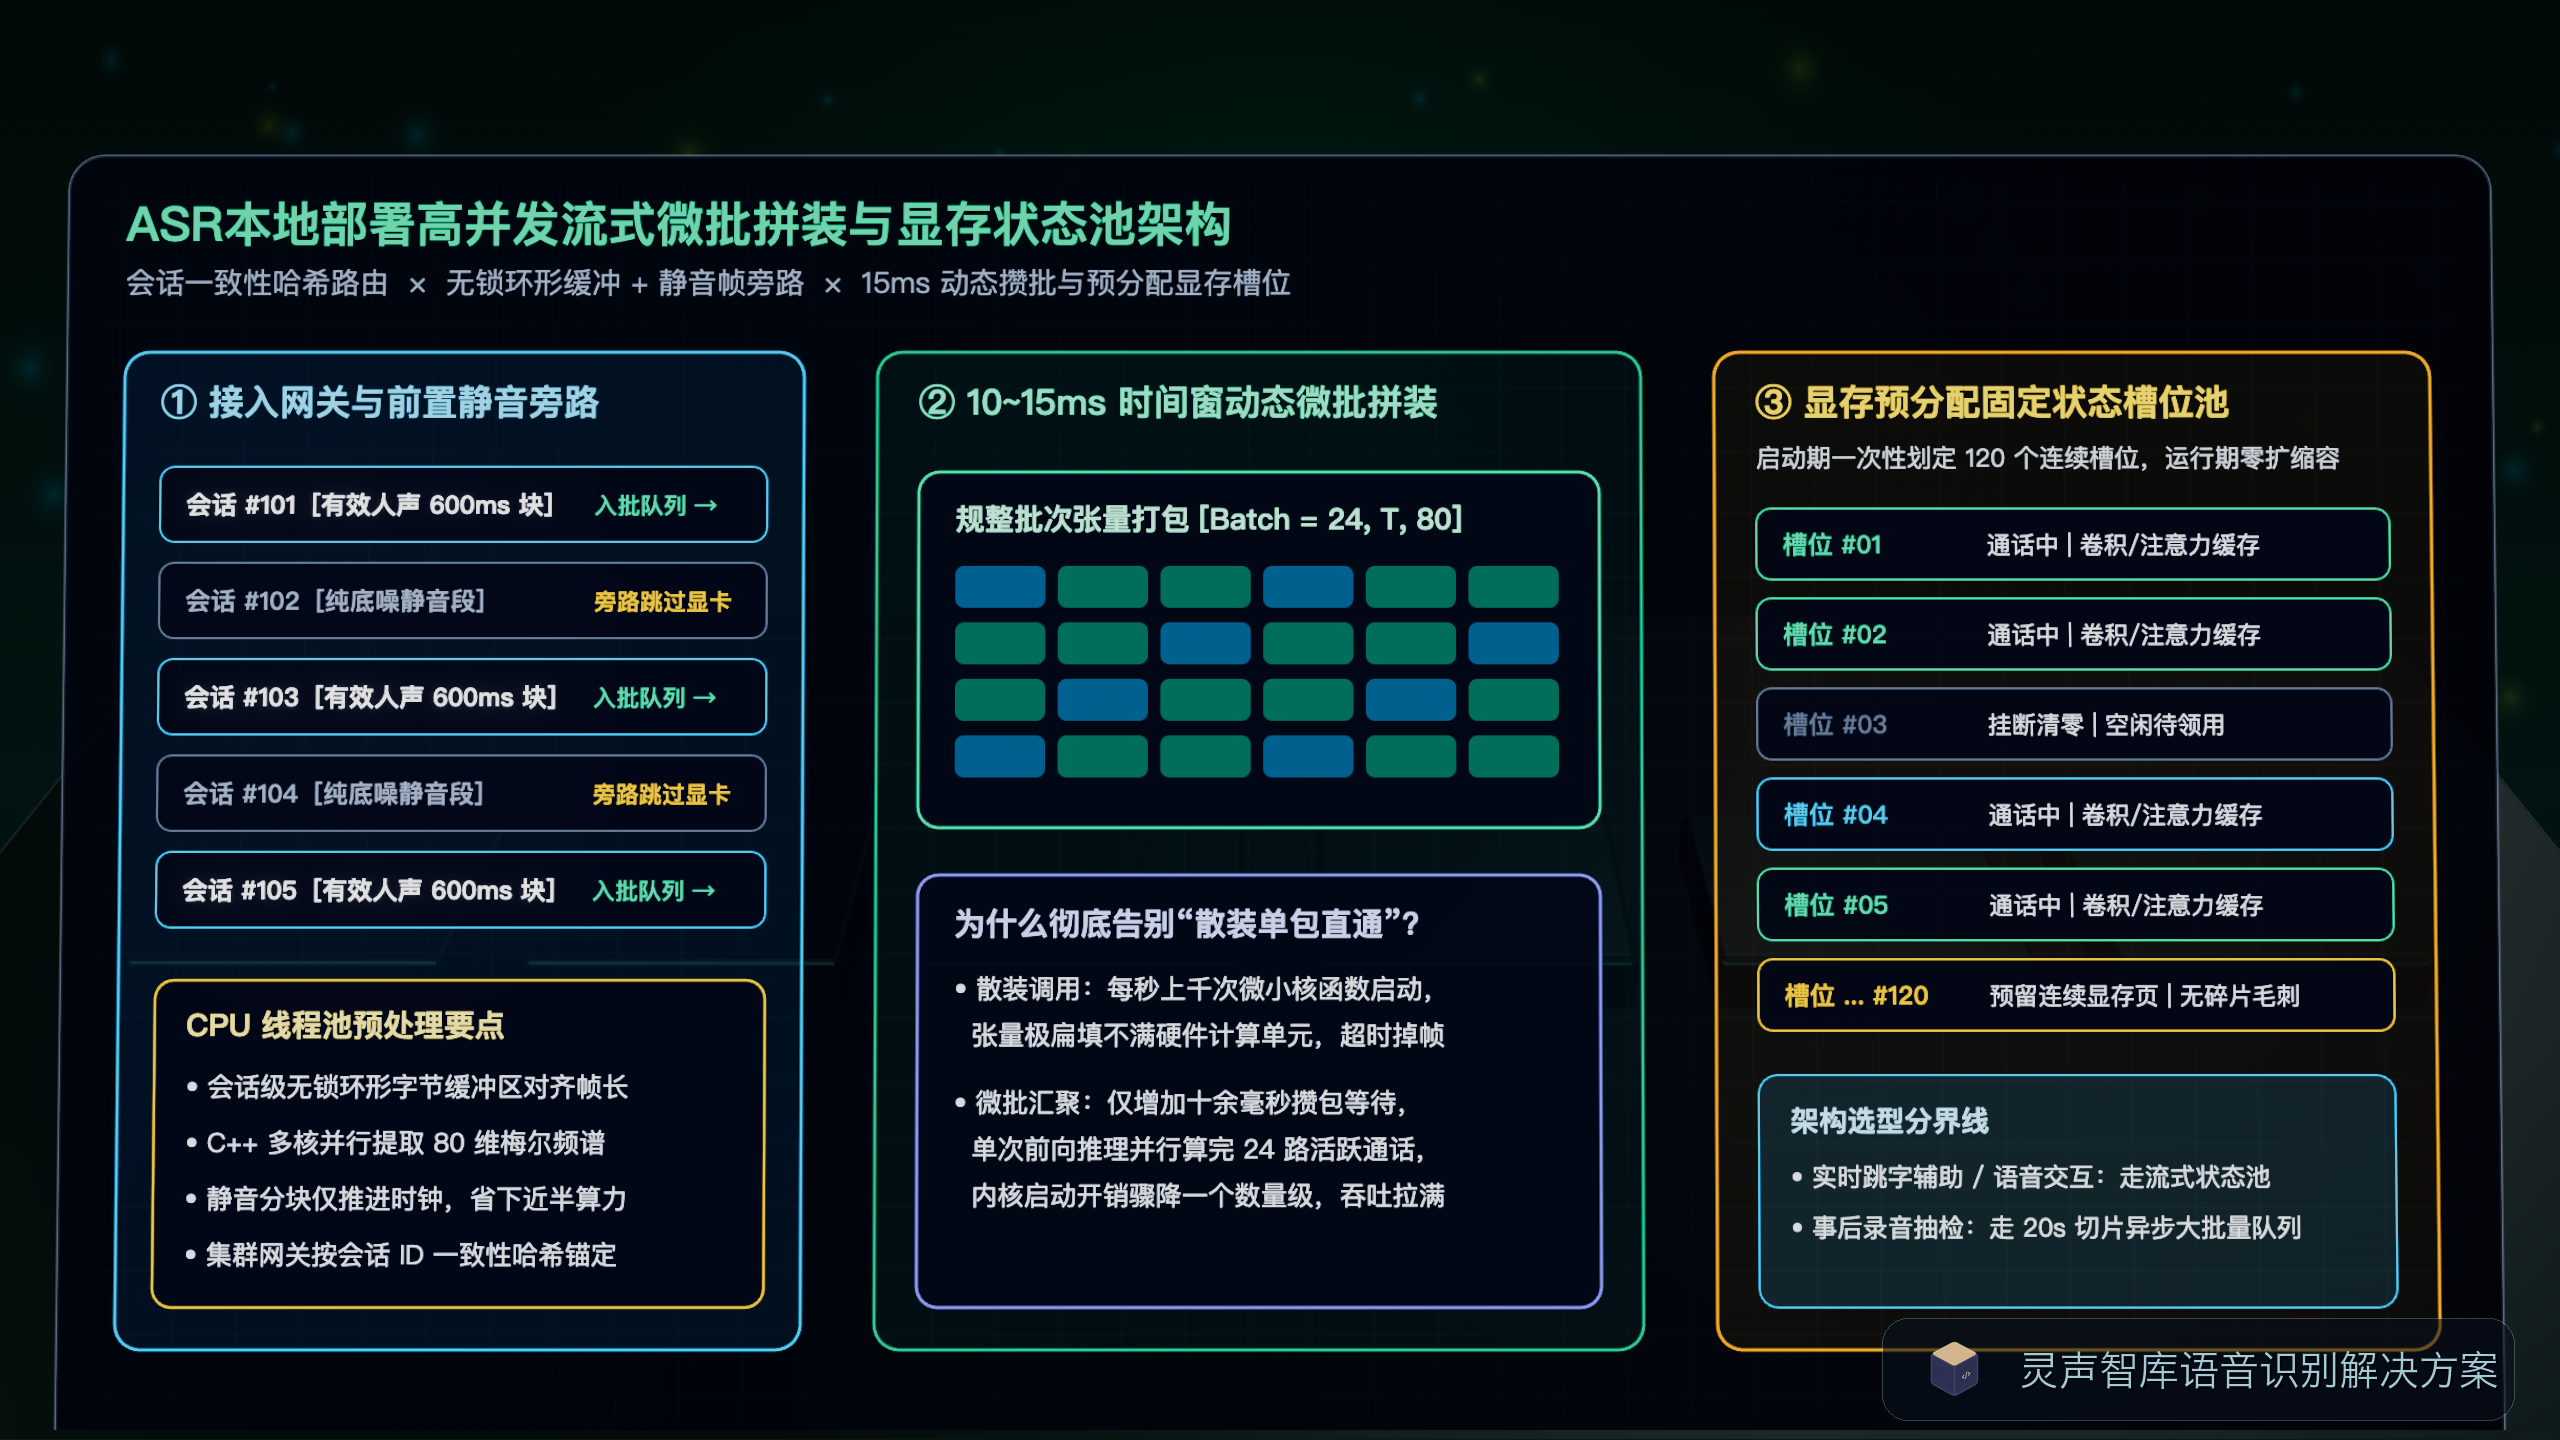
动态微批拼装与显存状态槽位池怎么搭
要把单卡并发路数真正榨出来,核心手术只有一刀:把“按连接触发推理”改成“按时间窗攒批触发推理”,并且为所有在线会话建立预分配的固定状态槽位池。
目前成熟的做法有两条路线。一条是基于 NVIDIA Triton Inference Server 配合序列批处理调度器,结合 FunASR 官方维护的运行时后端;另一条是直接用全 C++ 编写的 sherpa-onnx 流式服务端。不管选哪条路,底层的调度账本逻辑是一致的:假设每路电话每六百毫秒产生一个音频分块,调度器并不在收到包的瞬间立刻下发显卡任务,而是开启一个十到十五毫秒的极窄汇聚窗口。在这十五毫秒内到达的二十几路不同通话的音频块,连同它们各自在显存槽位池里对应的历史缓存索引,被一次性打包成一个批次维度为二十四的规整张量,单次核函数调用就能算完二十四路前向传播。
这么改完之后,客户端感知的等待时间仅仅多了十几毫秒,但显卡每秒承受的内核启动次数直接降了一个数量级,张量核心吞吐瞬间拉满。在服务进程初始化阶段,系统就按单卡规划的容量上限(例如一百二十个并发槽位)在显存里一次性划好连续的状态缓冲区。新电话进来领走一个空闲槽位号,挂断时只把该槽位的缓存清零归还池子,运行期全程不做显存动态扩缩容,从根源上消除长稳压测下的尾延迟毛刺。
还有一个极其省算力的实战技巧:前置静音旁路。真实双人通话中,一方在听另一方说话,或者坐席翻查资料时,单侧声道往往有一半以上的时间是纯背景底噪。把极轻量的端点检测跑在主机处理器工作线程池里,连续判定为静音的分块只做状态时钟推进、压根不送进显卡凑批,单张卡能承载的实际通话路数往往还能再往上翻近一倍。此前在灵声智库记录的热线网关压测复盘里,光加上静音帧旁路这一项小改动,晚高峰整机功耗和排队延迟就降下了将近四成。
什么时候该上分布式集群,什么时候干脆别用流式
当并发规模从百路迈向上千路,单机插满多卡也会撞上主板总线带宽和网卡中断瓶颈,这时就得引入分布式集群化部署。要格外留神的是,流式语音集群严禁用普通的轮询负载均衡器按数据包随机分发,因为同一通电话的前后音频块一旦落到不同机器上,显存里的上下文状态就断了。网关层必须基于通话会话编号做一致性哈希路由,确保整通电话从摘机到挂断始终锚定在同一台物理节点的同一个进程实例上;只有当某台节点水位告警摘除时,才对新呼入会话做重路由,并给存量连接留出六十秒优雅排空时间。
文末也得泼盆冷水,帮准备立项的团队省点真金白银:千万别不管三七二十一所有业务都按实时流式高并发去建集群。如果业务只是做柜面录音事后抽检、每日电话回访复盘,或者允许通话挂断后五秒到一分钟内出结果,直接走离线语音转写的整段切片异步消息队列,把长音频切成二十秒等长块做大批量非自回归推理,单卡日吞吐小时数比实时流式高出好几倍,运维复杂度也低不止一截。只有当屏幕需要实时跳字辅助坐席应答、或者挂接下游实时对话模块时,这套精细的流式状态池架构才真正值回票价。