在多模态生成式AI的演进历程中,自回归模型(Autoregressive, AR)一度确立了绝对的统治地位。从文本词元预测到声学波形代码生成,自回归模型依赖因果掩码,严格按照从左到右的时序一个Token接一个Token地串行吐字。尽管这种单向依赖机制在语言建模上表现出极强的因果逻辑连贯性,但当技术视线转向需要瞬时输出高清视觉图像、动态视频切片或连续高保真音频流的实时交互系统时,自回归模式那不可避免的串行时延墙(Latency Wall),瞬间沦为工业级落地的梦魇。
以生成一张包含1024个离散Token的图像为例,标准的自回归Transformer必须执行整整1024次前向传播,每一个步骤都受制于片外显存带宽的串行读写。即便学术界推行了成熟的推测解码(Speculative Decoding)或K-V缓存优化,端到端生成时延依然难以击穿秒级门槛。而主流的扩散模型(Diffusion Models)在连续空间虽然拥有极佳的平滑度,但其数十步高精度的去噪反向扩散计算同样消耗大量的浮点FLOPs。以Muse为代表的并行掩码离散生成架构(Masked Generative Modeling)彻底撕破了这一速度枷锁,通过将非自回归并行预测与跨模态注意力流形深度融合,为多模态个人助理的极速推演开拓出全新的技术蓝海。
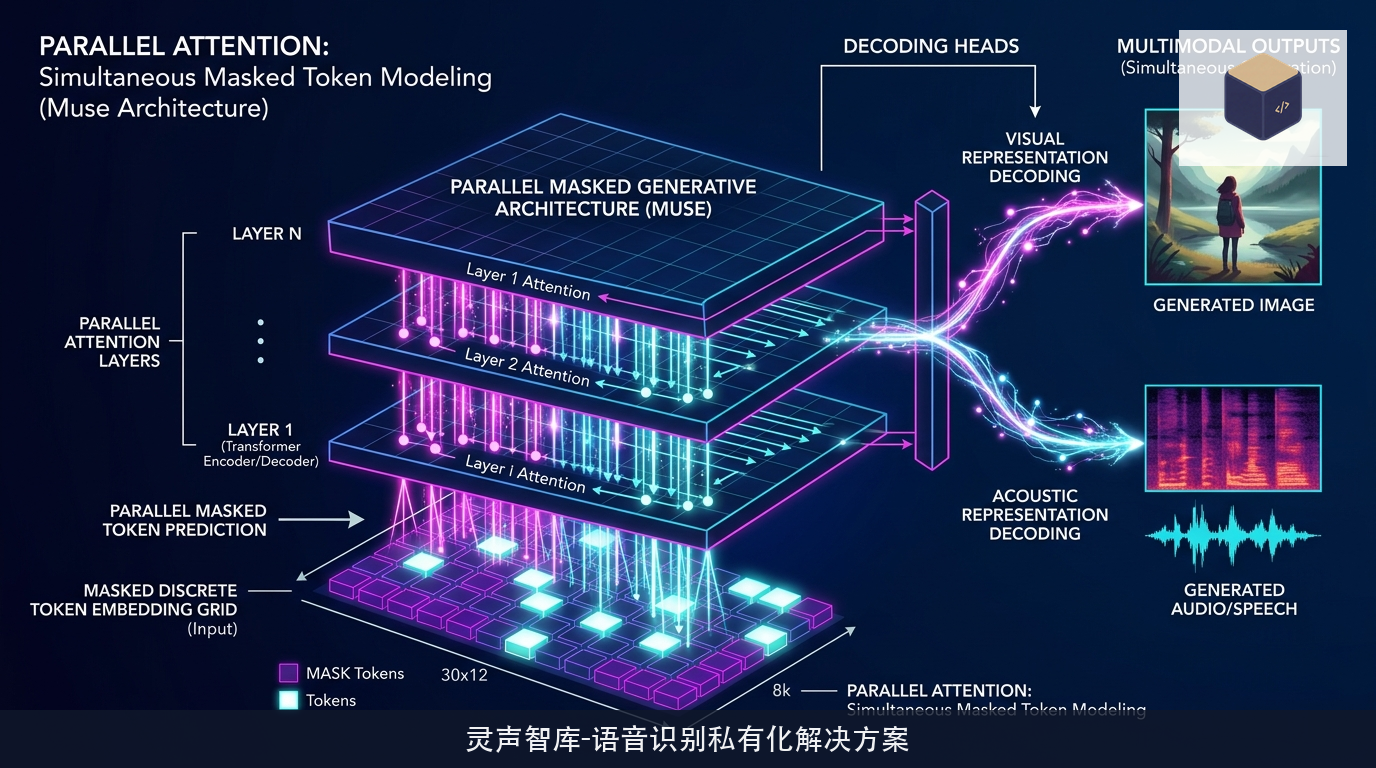
掩码离散量化空间与自适应并行迭代采样
Muse架构的核心哲学在于跳出自回归单向时序的狭隘视角,将多模态数据还原为统一离散编码空间中的全局联合概率建模。在输入端,高清图像或连续音频片段首先经过深层矢量量化变分自编码器(VQGAN或神经音频编码器),被压缩离散化为二维特征网格上的整数Token序列。在这一离散码本空间中,连续的物理信号被高度浓缩为具有明确拓扑关系的符号矩阵。
在生成推演阶段,Muse摒弃了逐字生成的笨拙过程,而是从全序列完全被特殊符号[MASK]掩盖的状态直接起步:
在第一轮迭代中,模型接收文本提示向量与全部掩码网格,通过双向非因果注意力机制同时评估网格中每一个位置的条件概率分布;
基于全局概率置信度,采样算法自适应选择置信度最高的一批预测值予以固定填充,保留剩余的低置信度位置继续掩盖;
在后续的迭代轮次中,模型持续利用已生成的稳定Token作为先验上下文,对剩余掩码区域实施并行联合修正;
为了避免模型在迭代中期陷入局部次优导致的码本坍塌(Codebook Collapse),系统在采样步长中引入了动态温度退火与高斯扰动抑制。当低置信度Token发生冲突时,双向注意力层能够利用全局上下文进行跨尺度的自发修复,绝不将早期错误层层放大。
这种基于余弦调度函数(Cosine Schedule)的渐进式解掩码机制,通常仅需8到16次前向迭代,便能使整个多模态特征网格完全收敛为结构严整、细节丰富的高保真内容。相比自回归模型上千步的漫长折磨,迭代步数直接被压缩了两个数量级,将图像与声学渲染的端到端时延一举压降至数十毫秒的实时交互区间。
跨模态双向注意力矩阵与特征对齐流形
让非自回归模型在极短步数内免于产生混乱斑块与结构扭曲的关键,在于跨模态特征在注意力空间内的深层几何对齐。在传统的级联流水线中,文本特征通常只是作为交叉注意力层(Cross-Attention)的被动查询项单向注入图像生成网络。
而在Muse架构中,文本提示向量、视觉潜Token与伴随生成的连续声学Token被直接投影映射至相同的几何流形空间:
模型在深层Transformer块中启用了动态可调的自适应注意力掩码矩阵。在早期粗粒度生成阶段,注意力矩阵允许视觉Token与文本Token进行大范围的双向全局特征交互,确保整体语义构图与用户意图的严格贴合;
随着去掩码过程步入细节雕琢阶段,模型自发收缩注意力范围,增强网格局部的稠密连接,专注于纹理精细化与边缘锐化渲染;
当引入并行音频生成模块时,声学特征流在时间轴上的变化率被严格绑定至视觉动作Token的演进节拍,从而在零额外同步对齐算法介入的前提下,原生实现了音画完全同频的流式多模态合成;
通过在不同推理步之间复用跨模态主干的键值缓存(KV-Cache Reuse),前向迭代间的重复特征计算被大幅削减,使得非自回归生成的每一步计算开销比标准自回归单步还要轻量。
这种流形对齐策略不仅大幅削减了跨模态桥接适配器的参数开销,更避免了不同模态生成速度脱节导致的缓冲区溢出危机,为轻量化多模态系统的端到端集成树立了标杆。
算力经济学重构:低显存占用与端侧实时助理落地
在数据中心及高端个人计算终端的能耗博弈中,Muse架构展现出了无与伦比的能效优势。传统的扩散模型虽然具备极高的画质上限,但其连续潜在空间的多次ODE/SDE数值求解需要耗费大量的浮点计算量,且去噪过程极难在低功耗NPU上进行定点化展开;而自回归模型又受制于高并发下的K-V Cache显存雪崩。
Muse凭借纯离散整数Token的特性,完美契合了现代计算加速器的微架构特质:
在内存占用维度,由于非自回归并行推演不依赖长时序自回归K-V Cache链条,单次推理的显存开销仅取决于当前批次与网络深度,静态内存占用呈现优异的常数级表现;
在算子适配层面,模型内部绝大多数计算密集型算子可以直接量化为INT8甚至低比特整数矩阵乘法,完全释放了嵌入式NPU高效向量单元的全部潜能;
实测表明,在无风扇移动端SOC芯片上运行针对个人助理优化的紧凑型Muse模型,不仅能够在百毫秒内完成复杂多模态图文界面的即时重绘,整机能耗更稳定控制在数瓦的极低功耗阈值内;
更重要的是,在实时交互场景中,个人助理可以根据用户的打断意图,动态中断当前去掩码循环,直接在上一次迭代的部分特征上进行快速局部编辑,完全无需像自回归模型那样全盘丢弃重新生成。摆脱了缓慢串行生成的束缚,这种毫秒级全模态爆发力,正让未来的个人助理从被动的冰冷文字应答者,蜕变为能够随用户话音落下而同步点亮丰富视听视界的灵动伙伴。