当个人AI助理从纯软件界面走出、栖身于桌面硬件底座、智能音箱、家庭服务机器人甚至穿戴式具身设备中时,其面临的感知挑战发生了根本性的质变。在纯净的软件测试集或近场降噪耳机环境中,哪怕参数量仅为数十兆的紧凑型语音识别模型也能轻松取得98%以上的转写准确率。然而,一旦将实体硬件置于真实的物理居室或嘈杂办公大厅中,开放空间中的声学退化现象瞬间让绝大多数云端算法暴露出惊人的脆弱性。
在真实的家庭与办公物理场景中,声学信号充斥着极其复杂的非平稳扰动:坚硬墙壁与玻璃幕墙造成的房间多径反射混响时间(RT60)动辄跨越0.8秒甚至1秒;客厅背景中电视机持续播送的新闻人声、厨房抽油烟机的强烈低频轰鸣,以及多名家庭成员在同一空间内的交叠抢话(Overlapping Speech),交织成极其混沌的声学混合物。如果具身个人助理在前置硬件环节无法完成物理维度的声源净化与空间分离,后端参数规模再庞大的大模型接收到的也只是一堆毫无语义价值的破碎乱码。要征服复杂的物理现实,必须在声学前端构建起空间流形波束成形与深度神经解耦的联合防线。
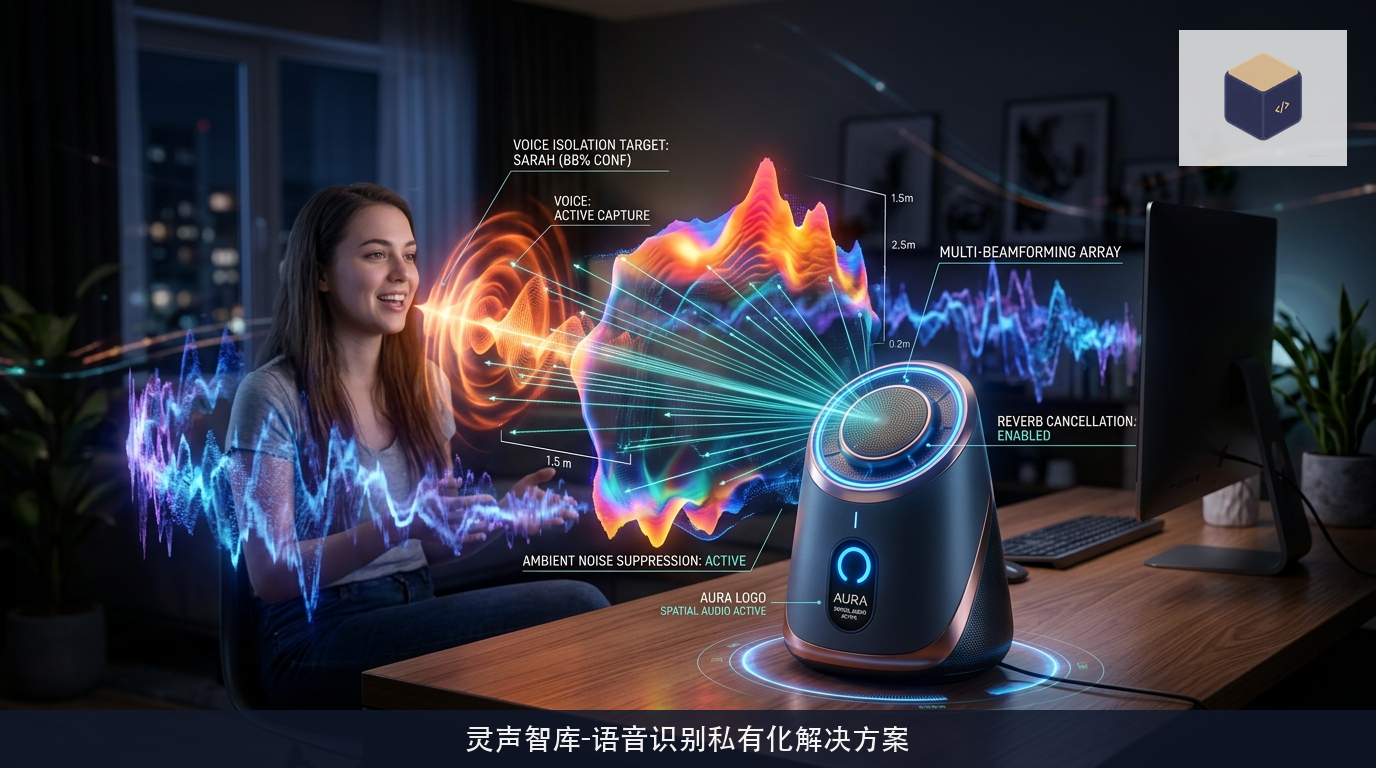
环形阵列空间波束成形与多径混响时空解耦
解决物理混响与远场拾音难题的第一道物理关口,是多麦克风环形阵列与空间波束成形(Beamforming)技术的深度协同。单颗麦克风只能被动记录标量气压波动,完全丧失了声音来源的方向与空间深度信息;而由4至8颗全向数字硅麦构成的多维阵列,能够通过微观纳秒级的到达时间差(TDOA),对三维物理声场展开空间流形重构。
在现代高密拾音硬件中,系统不再推行传统的固定静态指向波束,而是运行自适应微分波束成形(Differential Beamforming)算法:
阵列前端高速计算声波在不同麦克风之间的相位差向量,动态拟合出当前空间内的声能流向拓扑图;
算法在主说话人物理方位上自适应构建起一道主瓣极窄、副瓣极度抑制的高增益虚拟拾音通道,同时在持续发出噪音的背景声源(如空调出风口、电视机方向)所在坐标,精准布设深达数十分贝的指向性衰减零陷(Null Steering);
针对在室内反复弹跳的多径反射混响,系统引入了加权预测误差(WPE)时空去混响机制。通过分析前序数百毫秒音频与当前帧的长程线性预测相关性,精确估算出晚期混响的时域衰减尾迹,并从麦克风原始信号中实施相位抵消补偿。
这种在物理层面的空间净化,直接将复杂房间环境下的有效语音信噪比(SNR)拉升了15分贝以上,使原本糊成一片的浑浊声波瞬间被梳理出清晰的谐波脉络。
连续神经说话人分离与声纹定向追踪对齐
然而,物理波束成形在面对与目标用户物理位置极其接近、甚至处于相同声学锥形区域内的干扰人声时,依然会遭遇空间分辨率的物理极限。在家庭聚会或开放式工位环境中,多人同时开头发言是极其普遍的日常交互常态。
为了在无法依靠空间角度完全切分的极端工况下实现精准收听,端侧声学系统全面融合了连续神经语音分离(Continuous Speech Separation, CSS)架构:
神经分离网络直接在频域时频图或离散声学特征潜在空间展开推演。模型并不强行依赖固定数量的说话人预设,而是通过基于排列不变性训练(PIT)的目标函数,将交叠混合的复合音轨自适应分解为两条或多条互相正交的独立语音流;
更为关键的是个人助理与特定目标用户的声纹特征对齐(Target Speaker Extraction, TSE)。系统在本地非易失存储中持久化驻留了主用户的超紧凑声纹嵌入向量(Speaker Embedding,通常仅占数百字节);
当分离网络从交叠声波中拆解出多条潜在音轨时,声纹锚定头即刻在隐空间开展极速余弦相似度校验,毫秒级锁定哪一条音轨真正归属于该个人助理的合法主人,同时静默抑制其余无关路人或电视播报声。
这一机制彻底终结了过往智能设备在电视里有人呼喊口令便被误触发唤醒的滑稽场景,让具身助理在喧闹的人流中拥有了如同人类注意力机制(鸡尾酒会效应)一般的超凡听觉专注力。
边缘嵌入式芯片上的端到端低功耗流式部署
在实体硬件产品定义中,声学算法的工业化生死线永远取决于整机的热耗散与供电预算。如果在执行复杂的空间矩阵求逆与深度卷积分离时,需要时刻拉满高功率云端服务器或让端侧电池在半小时内耗尽,该方案便毫无落地价值。
现代具身助理声学前端在算子层面推行了彻底的轻量化重构:
全套空间滤波与神经分离网络全面适配固定时间步长的滑动窗口因果推演,严格杜绝全音频反向回溯;
在硬件映射维度,复杂的浮点张量运算全部被深度量化为8位定点整数(INT8),并在专用微型嵌入式数字信号处理器(DSP)或超低功耗NPU上实现硬件级指令融合;
在设备待机与非交互间隙,前端声学硬件维持在数十微瓦的极低功耗空间唤醒监测状态;只有当麦克风阵列探测到空间声场出现具备特定谐波特征的活跃人类语音时,才毫秒级分级唤醒后端深层神经分离核。
实测数据显示,整套兼具空间波束成形、去混响与多说话人定向分离的声学前端引擎,在典型端侧工控芯片上的端到端处理延迟被稳定压制在20毫秒以内,整机功耗仅占用极小的系统份额。正是这种在物理声学、微观半导体指令与端侧算法工程之间反复打磨出的深厚积淀,最终赋予了具身智能穿越物理世界喧嚣阻隔、随时清晰倾听人类心声的硬核感知力量。