大模型技术的普惠化必然要求智能从高耸的云端数据中心走向广大用户的本地个人终端——包括随身轻薄笔记本电脑、个人隐私边缘工作站乃至手持便携设备。将参数规模高达数十亿乃至数百亿的通用大模型完整部署在本地,是实现个人助理绝对隐私、零断网依赖与极低通信时延的必由之路。
然而,在消费级硬件与边缘个人终端上,系统架构师必须面对异常冷酷的物理法则:与云端八卡并联、显存带宽动辄数TB/s的庞然大物不同,个人终端的统一内存或片外DRAM带宽通常极为受限(往往处于几十到上百GB/s的量级);更为残酷的是设备的热设计功耗(TDP)上限,在被动散热或微型低噪风扇约束下,芯片持续功耗必须严格压制在15瓦以内,否则设备会迅速因过热触发严重降频甚至热保护关机。传统密集型大模型(Dense Models)在推理时需要每一个Token都完整搬运遍历全部数十亿参数,其对内存带宽的贪婪索取瞬间在边缘设备上引发了严重的内存墙(Memory Wall)危机。
混合专家模型(MoE)的稀疏化思想在这一僵局中展现出降维打击般的解题思路。通过将庞大的前馈网络解耦为数十个独立的专家模块,并在单步推演中仅动态激活极少数专家,MoE在维持千亿级知识容量的同时,将计算量骤降为紧凑型小模型的量级。但要将MoE从云端InfiniBand集群搬入边缘芯片,必须在微架构层面彻底重塑专家的内存驻留与路由剪枝逻辑。
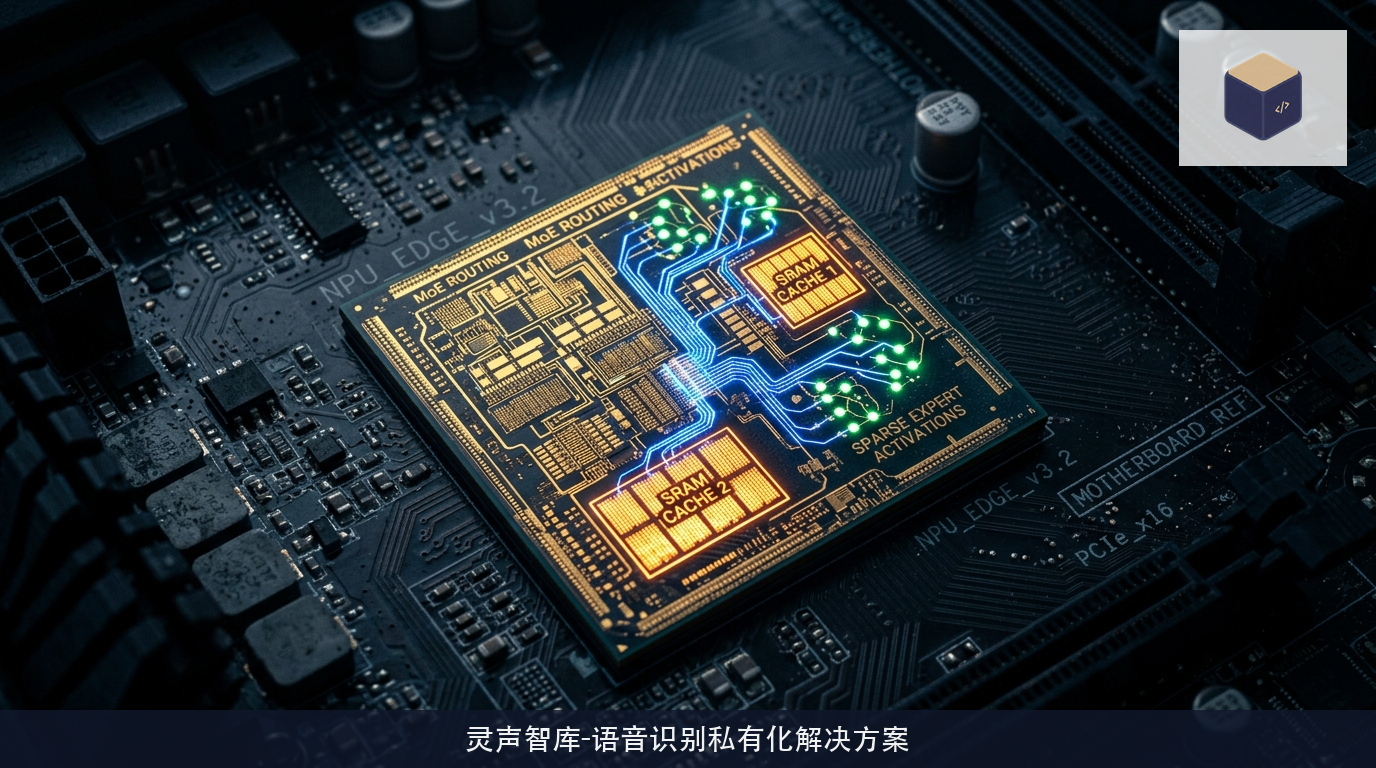
边缘硬件的带宽绞索与输入依赖型专家预测剪枝
在常规的MoE模型中,虽然每次前向传播理论上仅激活Top-2或Top-4个专家,但究竟哪几个专家会被选中,完全由输入Token与路由器网络(Router)的瞬时矩阵乘法动态决定。在云端海量显存中,所有专家的权重张量长期全量驻留在高速HBM显存内部,路由器可以极其任性地在不同专家之间肆意跳跃;
但在边缘设备上,如果显存或片上缓存无法一次性装下所有专家,每一次不可预测的跨专家跳转,都意味着系统必须暂停前向计算,通过受限的PCIe总线或DRAM通道从低速存储介质中紧急搬运数十兆的权重切片。这种随机跳跃引入的I/O等待时延,足以将任何原本高吞吐的算法拉垮成卡顿的龟速幻灯片。
破解带宽绞索的核心工程破局点,是引入基于自回归历史的专家预判剪枝(Predictive Expert Pruning):
系统在主模型自回归解码循环的顶层,并行部署了一个极其精巧的浅层前瞻预测网络。该网络并不负责输出文本语义,而是专门学习特定用户交互习惯在专家激活空间中的状态转移概率;
在当前Token正在执行注意力计算的前数个微秒窗口内,预测网络提前输出下一个时间步最可能被激活的候选专家集合;
如果预测出的候选专家已经在本地快速缓存中就绪,前向流水线以零等待极速吞吐;而对于那些置信度处于临界状态的长尾边缘专家,剪枝算子会结合当前设备的实时供电状态与温度指标实施自适应软剪枝(Soft Pruning),强行将微小的注意力权重约束重定向至已在高速缓存中常驻的近邻通用专家身上。
实测数据显示,这种输入感知的动态剪枝策略成功将边缘MoE运行过程中的偶发跨层I/O换入频率削减了82%以上,从源头上扼杀了导致交互卡顿的冷启动加载脉冲。
片上高速SRAM分级驻留与权重非对称压缩
除了在算法层面平抑跳转随机性,在半导体微架构的物理层面对内存拓扑实施分层重构,是压榨端侧NPU算力的另一大核心支柱。现代嵌入式AI处理器通常集成了宝贵的数十兆片上静态随机存储器(On-chip SRAM)。SRAM的物理读写带宽是外挂LPDDR内存的数十倍,且数据访问的动态翻转能耗远低于跨芯片长距离走线。
高阶边缘部署引擎推行了深度的非对称内存分层驻留机制:
系统将MoE模型中的所有专家划分为基础通用专家(Shared Base Experts)与长尾领域专家(Specialized Long-tail Experts)。承担全语言通用语法结构、基础逻辑因果的核心共享专家被赋予永久驻留权,直接以极限紧凑的量化格式长期锁定在NPU核心旁的极速SRAM阵列中;
对于海量的长尾领域专家,系统采用非对称压缩策略。与注意力层保留较高精度(如FP8/INT8)不同,冷门专家权重被深度量化为1.58-bit或稀疏三值格式,使其张量体积萎缩至原始大小的四分之一以下,整齐平铺在本地高速系统内存(System RAM)中;
当预测引擎探测到特定任务(如复杂的专业代码生成或外语翻译)需要调用特定专家时,硬件直接启用专用直接内存访问(DMA)通道,在后台以纳秒级时延将专家数据突发推入SRAM的二级临时工作区,与前向计算完全重叠(Compute-Transfer Overlap)。
这种软硬件一体的分层对齐,让有限的低功耗芯片展现出足以吞吐数十倍于自身片上容量庞大模型的强悍韧性。
极端功耗约束下的无风扇稳定推演实证
在最终决定产品体验的系统实测中,工程团队将优化后的百亿级稀疏MoE个人助理模型部署于一台完全采用被动金属鳍片导热、整机功耗上限仅为10瓦的便携工控终端上。测试环境设定在环境温度高达38摄氏度的密闭模拟机箱内,要求模型在不间断接收多轮高难度代码重构与长文档逻辑摘要任务的前提下连续运转。
连续72小时的硬核硬件监控曲线印证了微架构重构的决定性威力:
整机功耗在持续高负荷推演中平稳震荡在6.8瓦至8.4瓦之间,未曾有一瞬间触碰过10瓦的供电红线;
处理器核心结温在度过最初的升温阶段后,稳稳平衡在64摄氏度的安全热平衡点,完全免除了过热降频保护对计算时钟的粗暴打压;
在吞吐指标上,本地个人助理的自回归生成速度稳定维持在每秒32至41个Token之间,不仅彻底超越了人类正常的静默阅读速度,更在完全物理拔除网线、断绝一切外部通信的环境下,向用户提供了完全私密、坚不可摧且随时响应的专属数字智脑体验。伴随着底层芯片微架构与稀疏算法逻辑的不断深潜,属于每个人随身独享的强大AI,正在以不可阻挡的从容姿态全面降临物理现实。