大模型在生成式多模态(文本、音频、视觉及动作序列)领域的广泛落地,正在被一道物理层面的铁律无情掣肘——串行自回归(Autoregressive, AR)解码的单步延迟死锁。在标准自回归范式下,模型为了生成包含N个离散Token的完整输出序列,必须在GPU上周而复始地执行N次完整的前向传播。即便引入了静态编译优化与算子融合,这种强数据依赖的串行循环也彻底锁死了并发可能,导致长序列生成的端到端耗时居高不下。
在自动语音转写后处理、端到端实时流式语音应答以及视频动作序列控制等强交互业务中,动辄数秒的自回归等待会彻底摧毁用户的使用体验。为了斩断自回归生成的串行枷锁,工业界与学术界正在全力开辟第二条路线:非自回归神经生成(Non-Autoregressive Generation, NAR)与离散掩码流形迭代解码(Masked Discrete Diffusion / Flow Matching)。这一技术架构通过在单次网络前向传播中并行捕获双向全局依赖,将传统需要上百步的生成循环极限压缩至数个迭代步内,为多模态极速推理推开了全新天地。
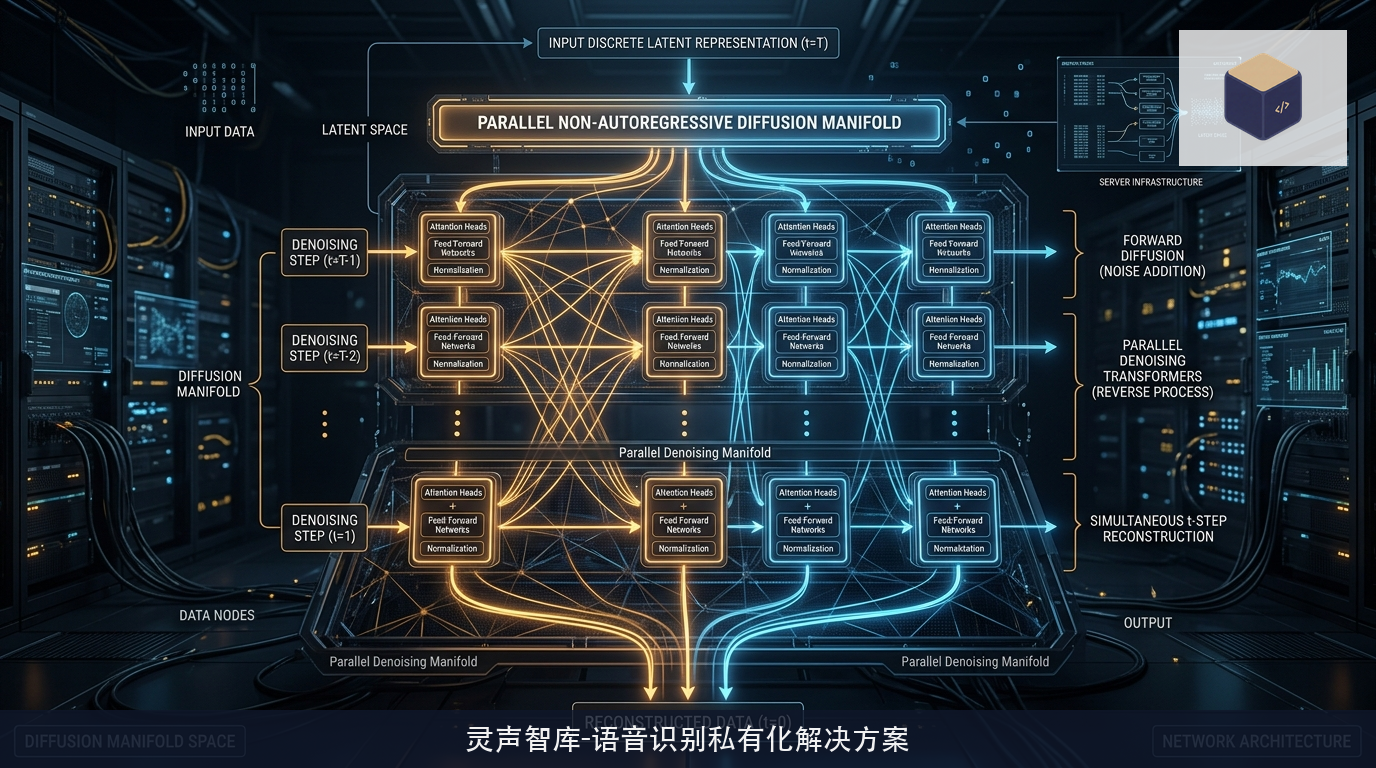
串行自回归的时钟瓶颈与非自回归的条件独立性困局
深入剖析自回归架构的计算微架构,其根源在于自回归模型假定目标序列联合概率可以严格因式分解为单向条件概率链条。这一假定赋予了模型出色的局部语义平滑度,但其硬件代价是灾难性的访存带宽浪费。在逐Token解码过程中,现代GPU强大的数千个浮点计算单元绝大多数时间处于饥饿空转,仅仅在等待几十微秒的显存权重读取完成;更为棘手的是,早期生成的错误字符无法在后文中被修改,产生不可逆的误差雪崩。
最初的非自回归生成尝试走入了另一个极端。早期的NAR模型假设目标序列的所有位置在给定输入上下文的前提下是相互独立的,试图通过单次前向传播同时吐出所有位置的预测。然而,这一条件独立性假设在复杂的自然语言与连续多模态信号中遭遇了毁灭性的多峰分布坍塌(Multi-modality Problem)。
例如在机器翻译或语义生成时,同一个输入短语往往拥有多种合法的主谓宾表达结构。纯粹独立的单步NAR模型在输出前半句时可能偏向第一种语法结构,而在输出后半句时又投向了第二种语法结构,导致生成的句子语法混乱不堪、词语大量重复。如何既打破串行时钟依赖,又完整保留全局自注意力依赖,成为了非自回归跨越玩具阶段的技术分水岭。
离散掩码流形与双向注意力的多步逐步去噪演化
离散掩码扩散架构(以Muse与MaskGIT思想为代表)的出现,完美弥合了单步独立性与完全自回归之间的鸿沟。
该架构将生成过程重构为一个离散状态空间上的迭代去噪过程。在初始状态下,一个固定长度的目标Token序列全部被特殊的掩码占位符 [MASK] 填充;网络并不试图在一步之内猜测出全部字符,而是利用全双向自注意力机制(Bidirectional Attention),让所有未被掩码的已知位置与被掩码的未知位置进行全局信息交互。
在第一轮迭代中,模型同时计算出所有被掩码槽位的置信度分布,系统随后根据动态退火调度表,仅挑选置信度最高的前20%或30%的Token予以解冻转正,保留其预测值;在第二轮迭代中,这些已经确定的局部骨架特征作为已知前置条件继续输入网络,网络再次利用双向注意力预测剩余的掩码部分,纠正潜在的语义偏航并解锁下一批次的高置信度Token;依此推进,通常仅需4到8个迭代步,整篇长序列的全部掩码便被完全还原。
这一机制在工程实现上带来了双重红利: 其一是双向注意力的表征优势。自回归模型在生成前缀时完全无法看到后文内容,而掩码扩散模型从第一个去噪步开始便在全序列范围建立长程全局感知,能够精准把控整段语义的宏观节奏与对称结构; 其二是计算利用率(MFU)的爆发。在每一个迭代步中,GPU执行的是大批量的全张量矩阵乘法(GEMM),彻底摆脱了自回归单向量矩阵乘(GEMV)的访存带宽瓶颈,显卡计算核心被瞬间拉满。
步长自适应蒸馏与并行计算内核中的极致吞吐榨取
虽然4到8步的掩码去噪相比于数百步的自回归循环已经实现了数量级的效率跃迁,但在高并发微服务与边缘计算场景下,工程师追求低时延的脚步从未停滞。如何将迭代步数进一步压榨至极简的2步乃至1步,成为工业落地的攻坚靶心。
渐进式蒸馏(Progressive Distillation)与一致性流形映射(Consistency Trajectory Models)在此处发挥了关键威力。系统首先训练一个具备16步高保真去噪能力的教师模型;随后通过一致性损失函数,强迫一个学生网络在单次跨步中直接预测教师模型跳跃两步后的去噪终点;通过多轮级联蒸馏,学生网络逐步学会了在极其稀疏的离散流形上进行跨步预测,在不牺牲生成逼真度的前提下,成功将推理迭代步数压缩至固定2步。
在底层C++推理引擎的工程落地中,技术团队重构了专用的非自回归算子流水线。由于非自回归模型的输入序列长度在去噪过程中是严格固定的,系统彻底摒弃了复杂的动态动态内存碎片管理(如KV Cache动态分页与内存整理)。所有中间张量直接在引擎初始化阶段分配好静态固定的连续物理显存,消除了任何运行时的动态显存申请开销。
同时,双向注意力的计算被深度重构为FlashAttention前向内核,完全无须处理自回归复杂的因果下三角掩码逻辑,内存读写效率逼近硬件物理带宽极限。在真实的万级长文本语义转写与动作预测高压测试中,这种优化后的并行引擎展现出了相较于传统自回归基线高达5.8倍的端到端吞吐提升,单请求P99延迟稳定压制在数十毫秒的超低水平。
从串行拘泥的机械流水线,走向全局协同的并行流形去噪,非自回归神经生成架构正在撕碎大模型交互时延的紧箍咒,让高速、流畅的跨模态即时智能在各类复杂工业场景中生根发芽。