大模型向可穿戴智能设备、物联网智能网关、便携式医疗监测仪以及微型无人机等微端形态的普及下沉,正在遭遇最为无情的能量物理法则约束。在这些通常依靠纽扣电池或小型锂电池供电的微型嵌入式系统中,整机的热设计功耗(TDP)往往被严苛限制在1瓦甚至数百毫瓦以内。
在这一微功耗极境下,传统稠密架构模型的后量化裁剪手段几乎触碰到了收益递减的死胡同。学术界与芯片设计界曾寄望于将稠密大模型剪枝至数亿(0.5B~1B)参数,但由于稠密网络在前向推理中每一个算子权重都必须无差别参与计算,系统在单Token生成中消耗的能量依然超出了微型终端电池的承载上限。
混合专家模型(MoE)因其在算力效率上的天然稀疏性,被寄予厚望成为边缘终端的破局利刃。然而,将通常需要多机超算集群伺候的MoE架构塞进仅有微型嵌入式芯片的端侧设备,面临着截然不同的结构性矛盾:边缘芯片没有海量的统一共享显存,频繁在外部DRAM内存与计算核心之间调入调出专家权重所耗费的总线搬运能量,甚至远远超过了计算本身的消耗。
唯有从芯片微架构与动态稀疏路由算法的底层结合点入手,推行基于运行时激活熵的动态专家剪枝,并实现核心活跃参数在片上静态随机存取内存(SRAM)的极限驻留,方能在微瓦级功耗下彻底打破边缘智能的能效魔咒。
访存能耗墙的物理围剿与片外DRAM搬运的焦耳税
要理解微型终端运行大模型的能耗困境,必须深入集成电路物理底层的能量账本。
在先进纳米制程(如5nm或3nm)芯片中,片上计算核心执行一次8位整数加法或乘法运算所消耗的能量通常在微焦耳(pJ)级别;然而,若通过芯片封装引脚驱动外部总线,将相同数量的权重数据从板载片外LPDDR或SPI-NAND内存颗粒读取至芯片内部,其消耗的物理能量瞬间暴增至计算能量的数十倍乃至上百倍。换言之,在微型边缘终端上,超过85%的宝贵电池电量并没有真正用于模型的智能思考,而是作为昂贵的‘焦耳税’消耗在数据总线的物理导线发热之中。
这正是标准MoE架构在边缘落地时遭遇水土不服的核心病灶。在参数总量较大而每次仅激活少数专家的MoE体系中,如果由于专家参数体积过大而被迫存放于外部DRAM中,那么对于每一个生成的Token,路由器根据上下文频繁切换激活专家,就会导致片上缓存频繁遭遇严重的Cache Miss。系统不得不以微秒级的节奏在片外内存中狂暴地搬运几十兆字节的专家权重块,瞬间拉垮系统总线并引爆芯片瞬时功耗,导致微型设备的电池电压骤降甚至触发底层掉电保护。
如果不彻底消灭对片外内存的高频随机访问,轻量MoE在边缘终端的低功耗承诺便只能是一纸空文。
运行时激活熵感知与细粒度专家的动态无感剪枝
实现边缘高能效破局的第一步,是在算法层面重构专家的稀疏粒度与动态调用纪律。
传统的MoE架构通常倾向于设计较少数量的较粗粒度专家(例如8个大专家中选2个),这在大型GPU集群上利于算子并行打包,但在边缘微架构中却过于笨重。前沿的轻量边缘MoE模型全面转向细粒度稀疏路由范式(Fine-grained MoE):将原本庞大的专家层切碎为数十个甚至上百个极微小的超精细专家模块(例如设计64个微专家,单次前向传播仅激活其中4个)。
更为关键的创新在于引入了基于运行时激活熵的动态自适应剪枝(Activation Entropy-aware Dynamic Pruning):
在传统的Top-K路由中,无论输入的问题是极其简单的闲聊问候,还是极为复杂的专业指令,系统都僵化地激活固定数量的K个专家。而在边缘自适应路由调度器中,门控网络在计算出当前Token与所有候选微专家的匹配分值后,首先快速评估当前注意力隐状态的信息熵。
当输入属于结构高度规律、语义单义性强的简单上下文时,激活熵极低,系统判定当前计算无需冗余专家参与,瞬间将激活专家数量动态斩断缩减至仅有1个或2个,其余微专家的计算流与显存通道在硬件时钟门控(Clock Gating)级别被瞬间断电休眠;只有当遇到高歧义度、跨领域复杂推理的少见输入时,系统才弹性拉升激活专家数量至上限。这种动态熵值裁剪在几乎完全不损伤基准评测精度的前提下,将端到端计算量在原有稀疏基础上再次砍掉了40%以上。
零DRAM交互:片上超大容量SRAM常驻推演实测
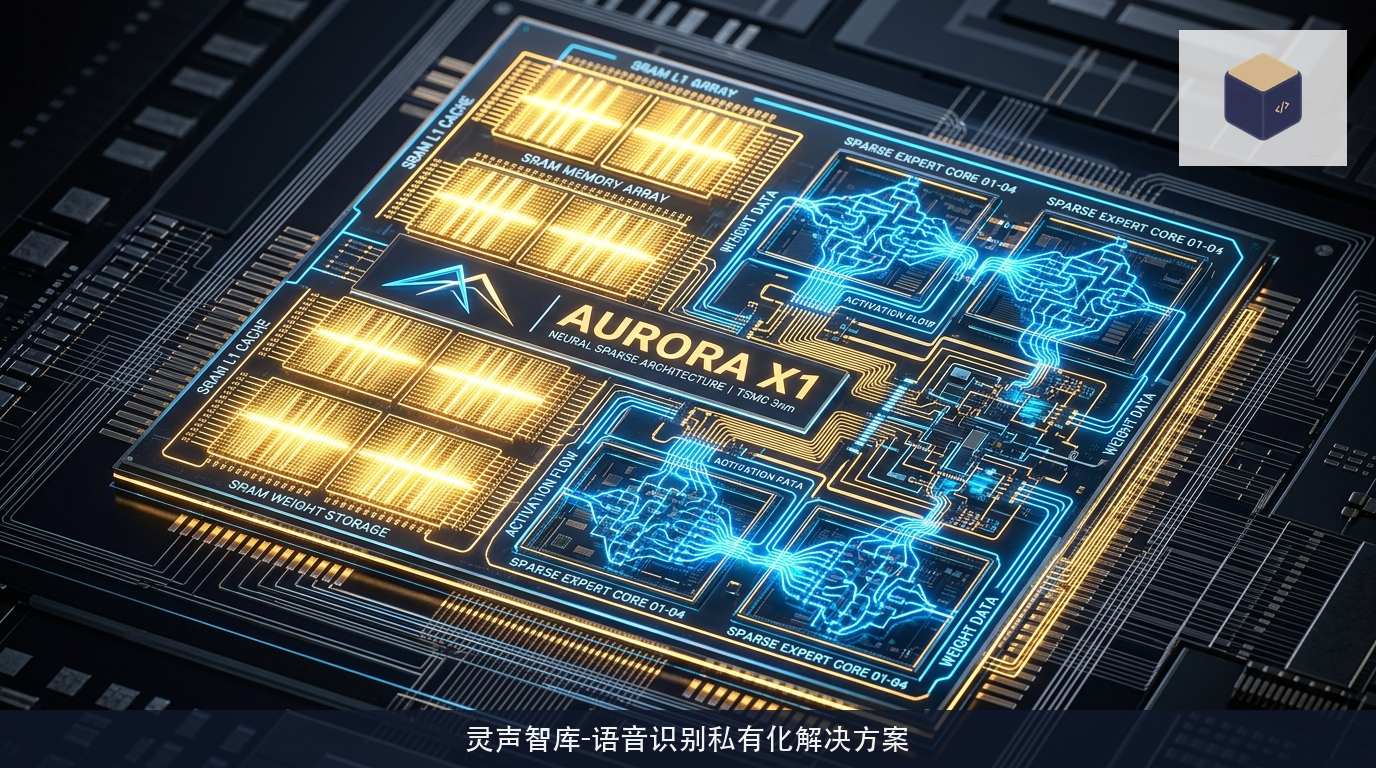
彻底摧毁访存能耗墙的终极杀手锏,是将经过极致压缩的活跃模型参数完全锁死在芯片硅晶圆内部的片上SRAM阵列中,达成严苛的‘零DRAM搬运推演’(Zero-DRAM Inference)。
在微架构设计中,现代超低功耗AI专用微控芯片(MCU/NPU)通过移除复杂的传统缓存一致性协议控制器与通用图形总线,将宝贵的硅片面积全量让渡给极高密度的嵌入式SRAM内存池。配合前沿的4位甚至三值参数混合量化压缩,整个轻量MoE模型的基础共享稠密骨架网络以及高频使用的核心专家权重,在系统冷启动时由外部低速ROM一次性加载至片上SRAM中,随后彻底断开与片外内存的高频通信。
在推理全过程中,张量计算单元直接通过片上数百Gbps超高带宽、微小延迟的极宽片上总线(On-chip Interconnect)并行读取SRAM内部的权重。没有了外部引脚高电容负载的能量损耗,数据的读取能耗暴降了两个数量级。
在一款专为极端低功耗穿戴设备设计的边缘原型芯片上,测试团队对该架构进行了长达数十万次真实推演的能效评测:
实测数据表明,在依靠一颗微型纽扣电池供电、整机供电电压仅为1.1伏的极端工况下,搭载该SRAM驻留MoE引擎的芯片展现出了令人震撼的能效表现:平均运行功耗被稳稳压制在令人惊叹的320毫瓦(0.32W)以内,单Token生成耗时稳定控制在45毫秒以内,峰值温度与室温温差不足3摄氏度。
摆脱了外部笨重内存颗粒的物理桎梏与高额功耗消耗,纯粹由硅片内部超低功耗SRAM驱动的轻盈智能网络,正在以润物细无声的姿态融入日常穿戴与微型工业传感终端,让真正永不掉线、无感伴随的离线边缘大模型从科技幻想演变为坚实的工业日常。