伴随具身智能(Embodied AI)技术浪潮的奔涌向前,人形机器人、四足仿生机器狗以及特种自动化作业终端正大步迈出实验室的温室,深入到现代化重工制造车间、特高压变电站巡检、地下矿井救援乃至嘈杂的人流公共空间。在这一物理实体落地的过程中,学术界与工业界长期将研发重心倾注于双目视觉SLAM、激光雷达点云建图以及关节力控伺服之上,却往往忽视了具身实体在物理世界生存交互的另一大核心感知支柱——听觉系统。
在实际工业部署实测中,由于听觉系统的脆弱而引发的感知失控事件屡见不鲜。当一台人形机器人身处冲压车间内部,面对高达90分贝的机械撞击轰鸣、强烈的厂房金属墙面多路径混响反射,以及现场多名作业工人互相重叠的交谈指令时,传统的单麦克风或朴素线性麦克风阵列算法瞬间陷入彻底的声学瘫痪:语音识别字错率(WER)暴增至80%以上,机器人无法分辨指令发自何方,甚至把机器本身的关节伺服电机啸叫误判为人类指令,产生严重的动作安全隐患。
为了让具身智能体在极端恶劣的物理声场中真正拥有听声辨位、去噪闻音的敏锐感知力,新一代声学感知架构正在从传统的几何滤波走向连续神经声学解耦与三维空间声场流形建模的深度融合。
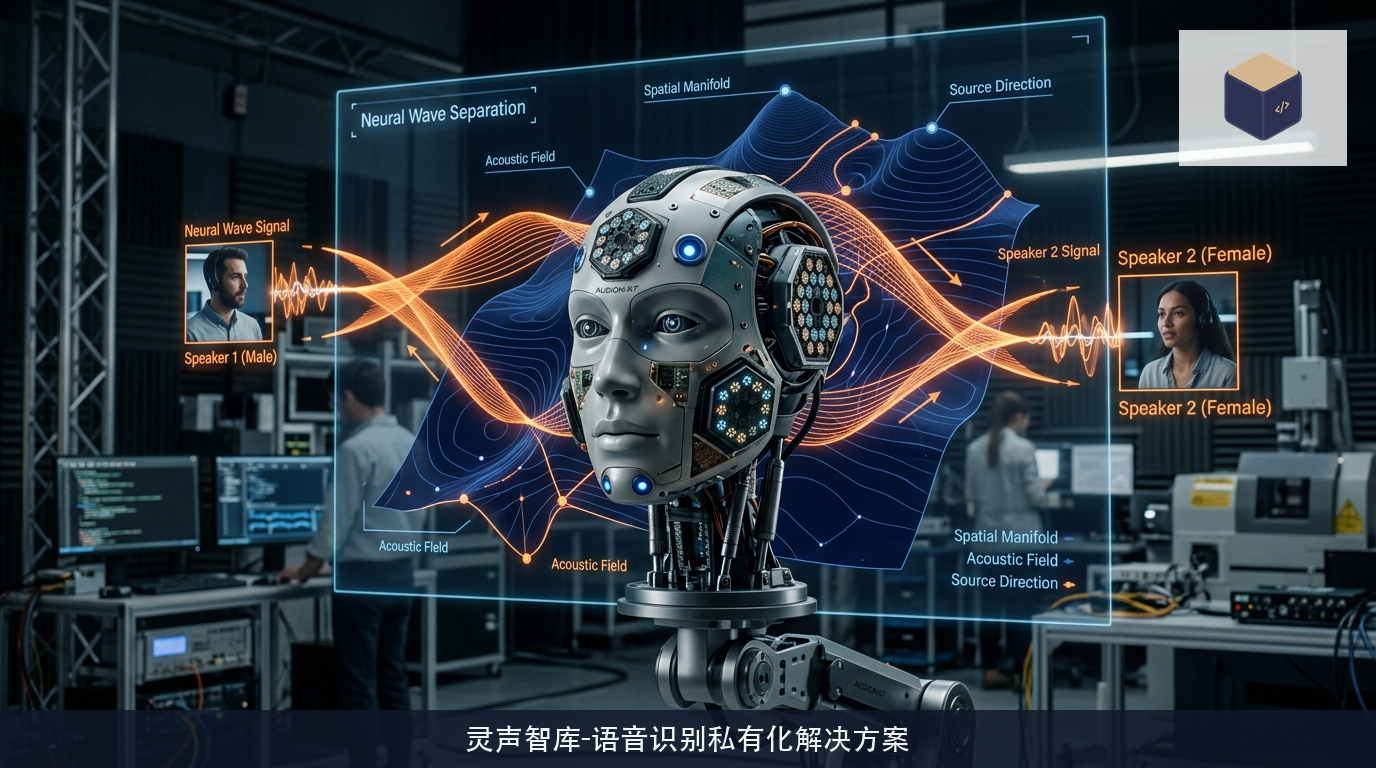
机器人本体自噪声与工业复杂声场的物理声学围城
审视具身机器人在工业现场面临的声学挑战,其首要致命难题并非来自远端环境,而是来自机器人机体自身的自噪声(Ego-noise)。
在人形机器人或多足机器狗的复杂机械构造中,高扭矩无刷伺服电机在频繁加减速时会产生高频电流啸叫与齿轮箱摩擦杂音;内部为了给高算力计算主板散热而配置的高速散热风扇,在密闭机体内形成强烈的气流湍流噪声;机器人在地面迈步行走或手爪操作工件时,机身骨架的物理刚性震动会通过机械结构直接传导至头部或胸部的拾音传感器。这些自噪声在传感器接收端形成的声压级往往远远超越了数米外人类说话人的声音能量,将目标信号彻底淹没在信噪比为负的声学泥潭中。
更为复杂的则是空间物理声学的非线性畸变。在工厂大型车间或狭长隧道中,声音在光滑的钢结构与混凝土地面之间发生数百次混乱的非弹性碰撞,形成长达数秒的后期重度混响(Late Reverberation)。混响不仅在时间轴上将前一个音素的尾音严重拖尾并覆盖后续音素,更在空间维度彻底打碎了声波的直达波阵面(Direct Path Wavefront),使得基于传统到达时间差(TDOA)的空间测向算法完全失去数学意义。
最后是重叠说话人场景下的鸡尾酒会难题。现场往往存在指令发布者、旁边无关操作工的闲聊以及广播喇叭的声音在同一毫秒级窗口内物理混叠。如果机器人无法在信号层面完成端到端的声学解耦,后端的语言理解模型将彻底沦为无本之木。
球谐函数空间波束成形与流形隐空间的连续盲源分离
攻克这一复合声学困局的基石,是构建基于非共面三维多麦克风刚体阵列的球谐波束成形(Spherical Harmonics Beamforming)前端。
工程团队在机器人的头部刚体外壳上,以非对称几何拓扑科学镶嵌了8至16颗高动态范围硅麦克风。由于机器人头部刚体本身的散射与衍射效应,声波在不同麦克风之间不仅产生相位差,更产生了频率依赖的声影遮挡效应。
算法并不采用传统的平面波模型,而是利用球谐函数级数将三维空间声场展开为正交基流形分解。通过实时计算声场在球面上的高阶能量拓扑分布,波束成形网络能够以度为精度单位,在三维半球空间内构建起具有极深零陷(Null-steering)的自适应定向波束。在硬件底层,波束成形器时刻将主瓣对准正在发话的目标操作员,同时在产生电机自噪声的机器人关节方向以及主要物理反射面方向精确压下深达数十dB的物理衰减陷阱。
在空间声场定向抽取之后,信号进入连续神经声学解耦网络(Continuous Neural Acoustic Disentanglement)。该网络构建于时域卷积与残差通道注意力基础之上,彻底摒弃了传统短时傅里叶变换(STFT)受制于时频分辨率折中的不确定性原理。
网络直接在时域微观连续波形上运行盲源分离(BSS)算法,将经过波束成形初筛后的混合信号映射至高维潜在声学流形空间。在这个流形空间中,不同说话人的声纹解剖学特征、房间脉冲响应(RIR)混响特征以及宽带机械加性白噪声被投影至正交的隐状态子空间。随后,生成式神经去混响解码器精准剥离后期反射杂音,重构出犹如在消音室近距离拾音般的纯净单说话人直达声波形。
具身听觉注意力焦点与跨模态视听联合定位实战
在真实复杂的交互工况中,纯粹依靠声学信号依然存在偶发性的空间方位模糊(例如空间中存在对称的虚假声源反射镜像)。具身智能体的终极优势在于其拥有跨模态的物理身体与多传感器融合能力。
前沿感知系统构建起了深度的视听跨模态注意力焦点机制(Audio-Visual Gaze & Saliency Coordination):
在宏观常态监控下,三维声场流形网络充当系统的超视距预警雷达。当视野之外(例如机器人侧后方或视线盲区)突然传来人类呼叫指令或异常金属断裂报警声时,声学引擎在50毫秒内完成到达角(DOA)估计,并将该空间三维矢量通过总线瞬间派发给机器人的颈部高动态伺服云台;机器人头部在100毫秒内完成物理快速转向,将高分辨率双目立体视觉相机对准发声来源区域。
到达视觉捕获阶段后,系统立即启动跨模态深度对齐。视觉神经网络在视野中极速定位人类面部的唇部运动起振特征(Lip-reading Motion),并将唇动光流特征与接收到的声学声谱进行微秒级时间同步相关性检验。只有当视觉唇动时序与声学信号特征高度耦合时,系统才最终锚定该目标为合法指令源,并将视觉提取的精确三维空间坐标反哺给声学波束成形器,将声学定向聚焦点死死锁定在该说话人的口唇空间坐标之上。
通过将物理层面的三维空间声场拓扑重构、隐空间的连续神经盲源分离,与物理实体的视听跨模态协同伺服深度熔铸为有机整体,具身智能体终于彻底冲破了极端工业声学的混沌围城,在钢铁轰鸣与机械交响的嘈杂现实中,稳健、精准地聆听并理解人类指令,为工业智能的真正落地筑牢了坚不可摧的感知基石。